Polska idzie do sądu z Google. Wytyczne dotyczące tworzenia tzw. main content. Nvidia pokazuje platformę chroniącą nasze zasoby przed samowolką agentów AI. Google omawia, ile trwają procesy związane z crawlowaniem i indeksowaniem. Teksty AI trzeba ręcznie sprawdzać przed publikacją. Shopify rozwija agentic commerce. Duże sklepy są faworyzowane w odpowiedziach AI – badanie. Funkcja wirtualnej przymierzalni w ChatGPT.
W skrócie:
- Google zmienia wytyczne dotyczące contentu – z naciskiem na tzw. main content.
- Nvidia tworzy zabezpieczenia przed agentami AI – nowa platforma pozwala izolować agentów i kontrolować ich dostęp do firmowych zasobów.
- Google zdradza więcej na temat crawlownia i indeksowania – poznaliśmy konkretne dane dotyczące czasu potrzebnego na poszczególne etapy przetwarzania stron.
- Google wymaga ręcznej kontroli treści AI – przed publikacją należy sprawdzić wygenerowane materiały pod kątem faktów, dokładności i wiarygodności.
- Shopify rozwija agentic commerce – agenci AI mogą już obsługiwać checkout, choć finalna zgoda na zakup nadal należy do użytkownika.
- AI preferuje duże sieci handlowe – badanie Vaer AI pokazuje, że mali i lokalni sprzedawcy znacznie rzadziej trafiają do głównych rekomendacji modeli.
- ChatGPT pozwala wirtualnie przymierzać ubrania – wystarczy selfie i zdjęcie kwalifikującego się produktu, aby wygenerować wizualizację.
1. Polska idzie na wojnę… z Google
Polski Urząd Ochrony Konkurencji i Konsumentów wszczął postępowanie wobec Google w sprawie sposobu negocjowania wynagrodzeń z polskimi wydawcami prasowymi.
Chodzi o pieniądze za wykorzystywanie treści wydawców w usługach Google, m.in. w wynikach wyszukiwania, w Google News oraz Discover. Problemem nie jest sama wysokość proponowanych stawek, ale sposób, w jaki Google miał dochodzić do konkretnych kwot.
Według UOKiK-u wydawcy mieli otrzymywać propozycje wynagrodzenia bez dostępu do wystarczających informacji o tym, jak zostały one wyliczone.
Warto wiedzieć
Polski wydawca mógł dostać od Google konkretną kwotę za wykorzystanie swoich treści, ale niekoniecznie wiedział, na jakiej podstawie została ona ustalona. A bez takich informacji trudno skutecznie negocjować i sprawdzić, czy oferta nie jest w jakiś sposób zaniżona.
Sprawa ma związek ze zmianami polskiego prawa autorskiego z 2024 r., które dały wydawcom podstawę do ubiegania się o wynagrodzenie za używanie ich publikacji przez platformy internetowe.
Jeśli strony nie dojdą do porozumienia, wysokość wynagrodzenia może zostać ustalona przez UKE.
Co ważne, samo wszczęcie postępowania nie oznacza jeszcze, że Google naruszyło polskie prawo. UOKiK dopiero bada sprawę i będzie ustalał odpowiedzialność poszczególnych spółek.
To przykład szerszego problemu, który pojawia się przy relacjach Google z wydawcami: kto i na jakiej podstawie powinien decydować o wartości treści wykorzystywanych przez wyszukiwarkę i AI.
W tym konkretnym przypadku UOKiK skupia się przede wszystkim na tym, czy wydawcy mieli wystarczająco dużo informacji, żeby negocjować z Google na równych zasadach.
2. Nowe wytyczne w dokumentacji Google dotyczącej tworzenia wartościowych treści
Google zaktualizowało wytyczne dotyczące tworzenia pomocnych, wiarygodnych treści, a jedna z ważniejszych zmian dotyczy kategorii main content, czyli głównej treści strony.
Jej jakość ma duże znaczenie przy ocenie serwisu – zwłaszcza to, czy rzeczywiście realizuje ona swój cel i odpowiada na potrzeby użytkownika.
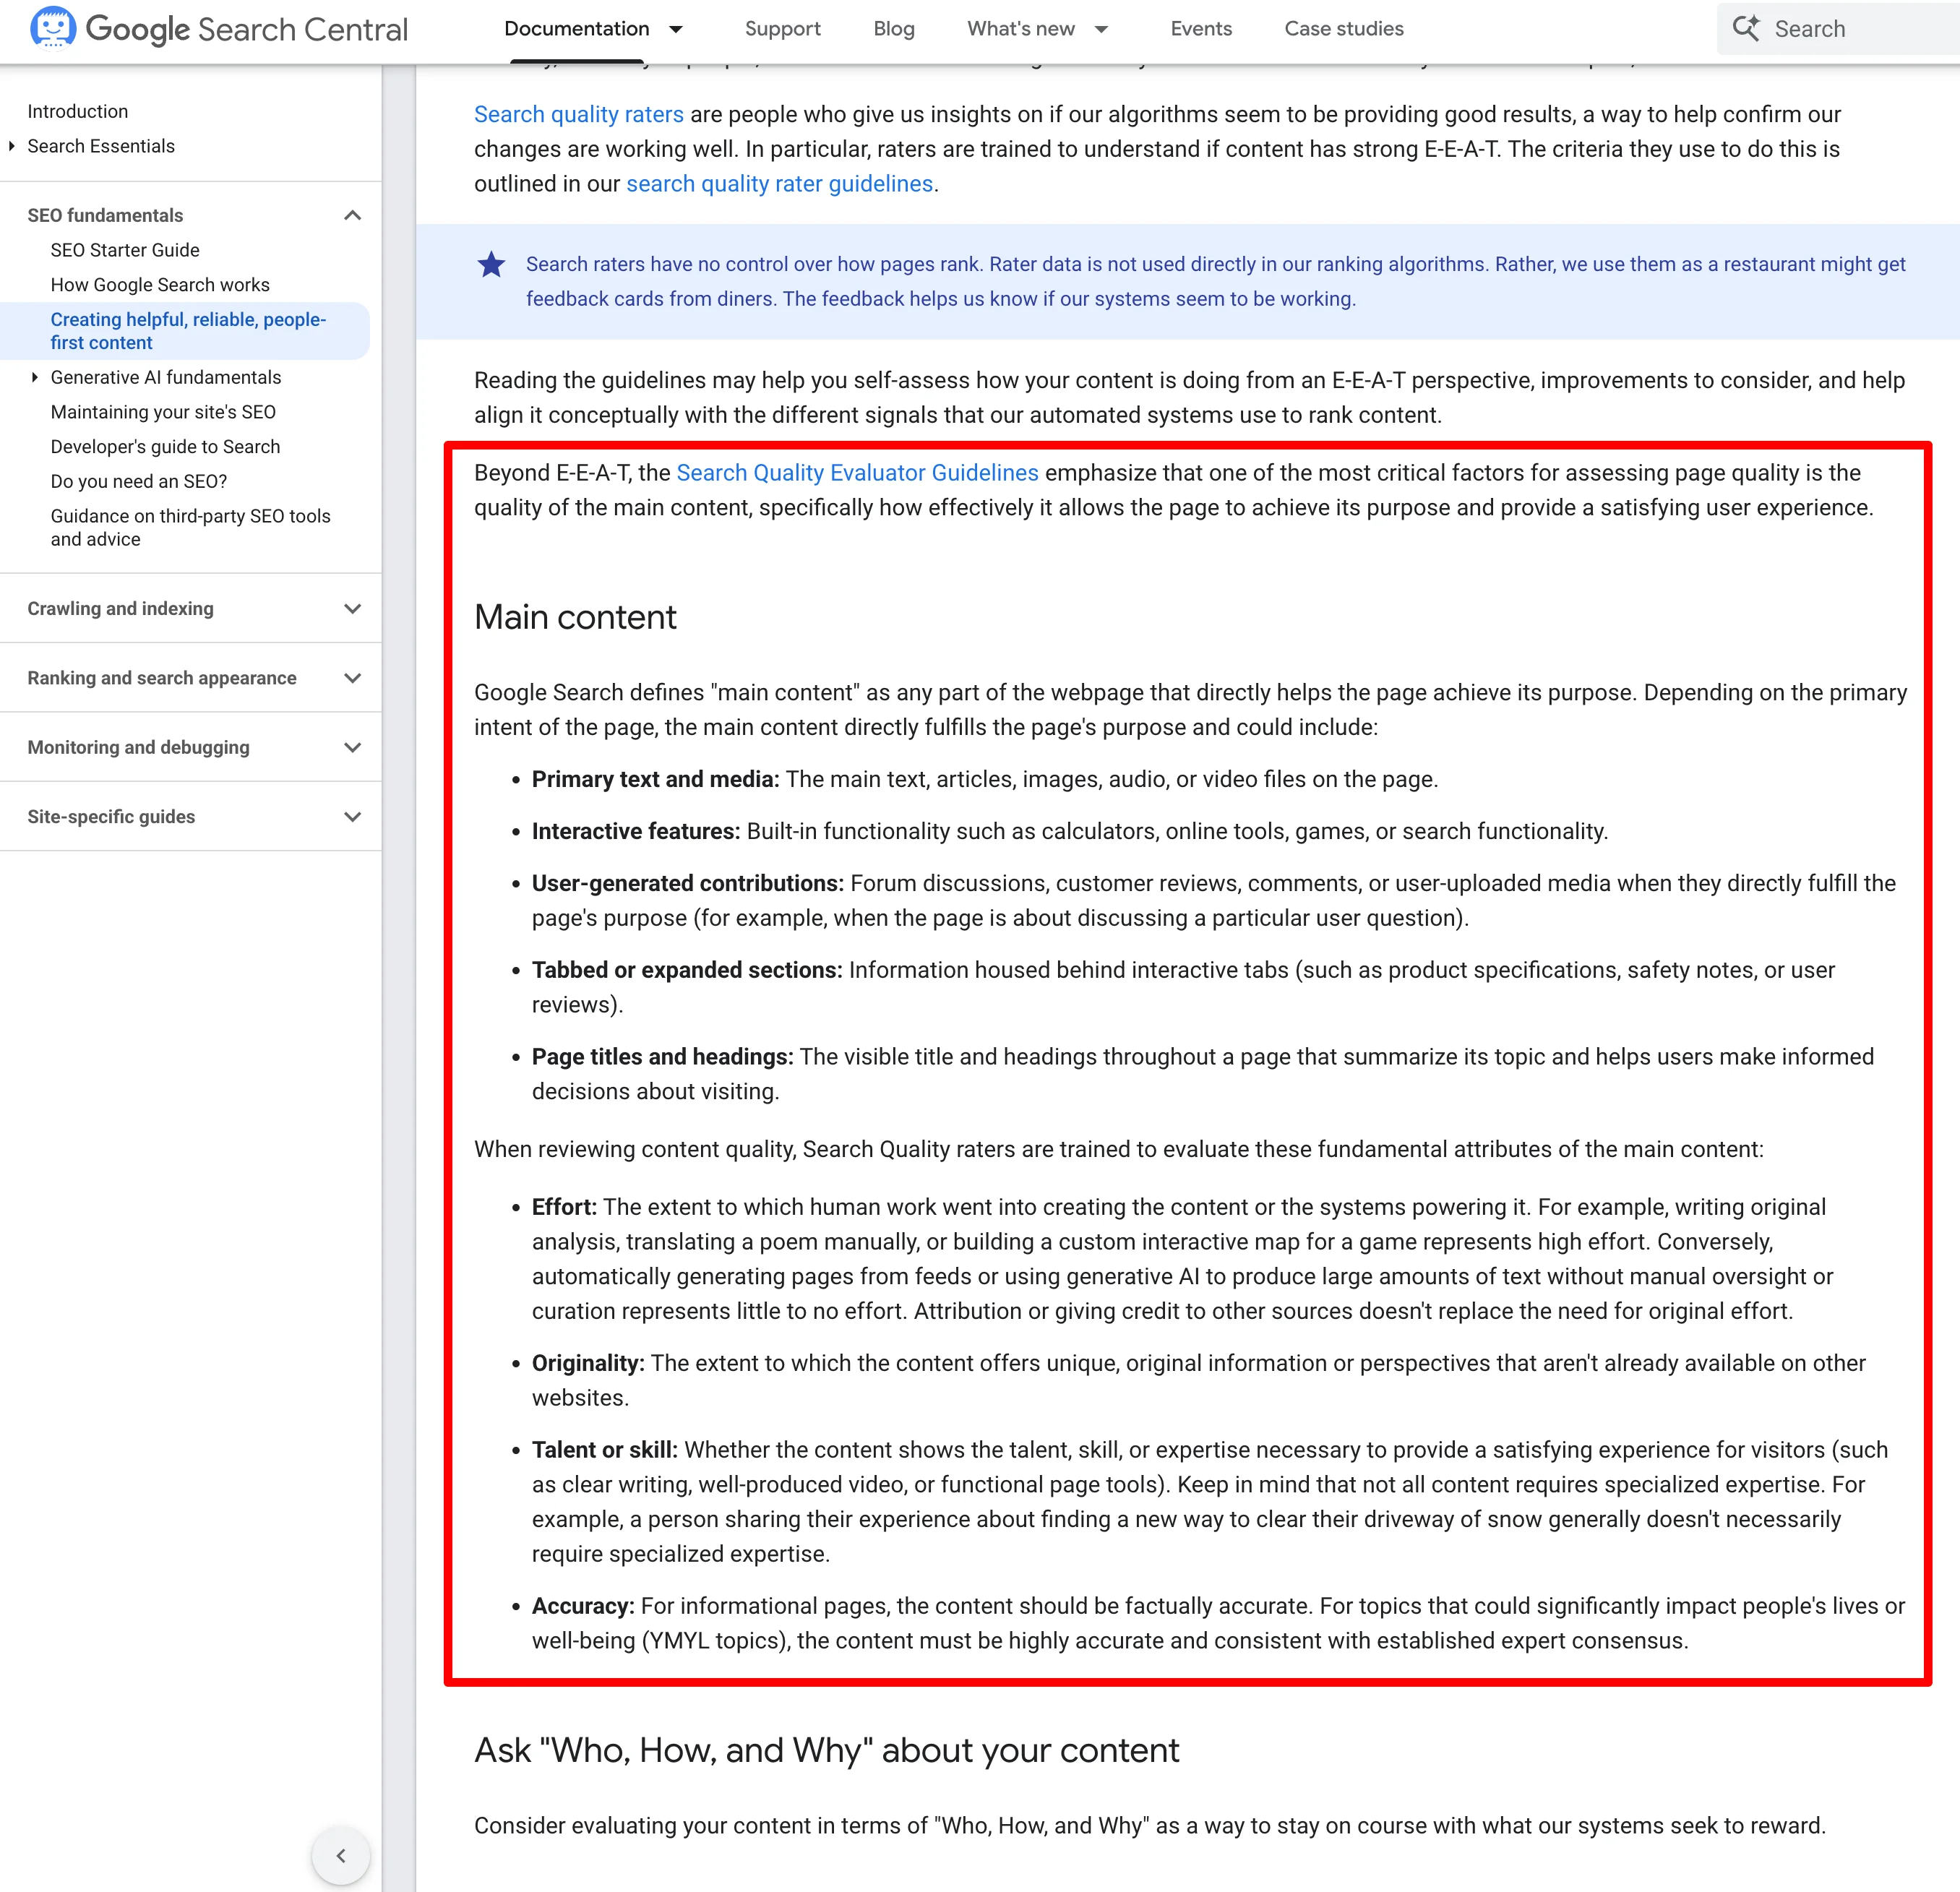
W nowej dokumentacji Google zwraca uwagę na cztery elementy:
- Wysiłek (Effort) – mówi o tym, ile rzeczywistej pracy włożono w przygotowanie treści albo systemu stojącego za stroną.
- Oryginalność (Originality) – Google ocenia, czy treść wnosi unikalne informacje albo perspektywę, których użytkownik nie znajdzie w takiej samej formie na innych stronach.
- Umiejętności (Talent or skill) – umiejętności potrzebne do stworzenia wartościowego „doświadczenia” dla użytkownika.
- Dokładność informacji (Accuracy) – w przypadku treści informacyjnych dane powinny być zgodne z faktami. Przy tematach YMYL wymagania są jeszcze wyższe, m.in. zgodność z ustalonym konsensusem ekspertów w danej dziedzinie.
Co ciekawe, main contentem nie musi być wyłącznie tekst. Mogą nim być również zdjęcia, wideo, narzędzia, kalkulatory, mapy, opinie czy treści tworzone przez użytkowników, a nawet widoczne na stronie tytuły i nagłówki.
Google jako przykład niewielkiego lub zerowego wysiłku wskazuje masowe generowanie treści AI bez ręcznego nadzoru. To nie AI jest złe, tylko co najwyżej sposób jego wykorzystania.
Samo użycie sztucznej inteligencji nie zastępuje pracy, oryginalnego wkładu ani kontroli jakości.
3. Nvidia uruchamia platformę „chroniącą” zasoby przed agentami AI
Nvidia zaprezentowała Open Agent Safety Platform – rozwiązanie, które ma zwiększyć bezpieczeństwo naszych plików i systemów przed autonomicznymi agentami AI.
Firma wychodzi z założenia, że skoro agent może samodzielnie korzystać z plików, sieci, API czy danych uwierzytelniających, trzeba też kontrolować, co dokładnie wolno mu zrobić.
Platforma OASP składa się z dwóch głównych elementów:
- Nvidia OpenShell, czyli warstwy programowej do izolowania i kontrolowania agentów;
- Nvidia Sentry, czyli warstwy sprzętowej opartej na układach BlueField-4, która stale monitoruje zachowanie agentów.
OpenShell tworzy dla agenta izolowane środowisko i pozwala ustalać konkretne zasady dostępu. Domyślnie obowiązuje model „default deny”, czyli agent nie dostaje dostępu do zasobów, jeśli nie zostanie mu on wcześniej przyznany.
Można też rejestrować działania agenta na potrzeby audytu.
Warto wiedzieć
Nvidia pokazuje cały proces na przykładzie Claude Code, który może zostać zablokowany przed wysłaniem kodu do GitHuba, dopóki użytkownik nie nada mu odpowiednich uprawnień.
Co ważne, OpenShell jest oprogramowaniem open source i nie wymaga korzystania ze sprzętu Nvidii.
Ogólny zamysł sprowadza się więc do jednego czynnika: zaufania. Nie możemy zakładać, że agent będzie zawsze posłuszny instrukcjom i lepiej technicznie ograniczyć to, co faktycznie jest w stanie zrobić.
Przy coraz bardziej autonomicznych asystentach AI takie podejście może stać się jednym z ważniejszych elementów bezpieczeństwa firmowych systemów.
4. Ile czasu Google potrzebuje na crawl i indeksowanie? G. Illyes odpowiada
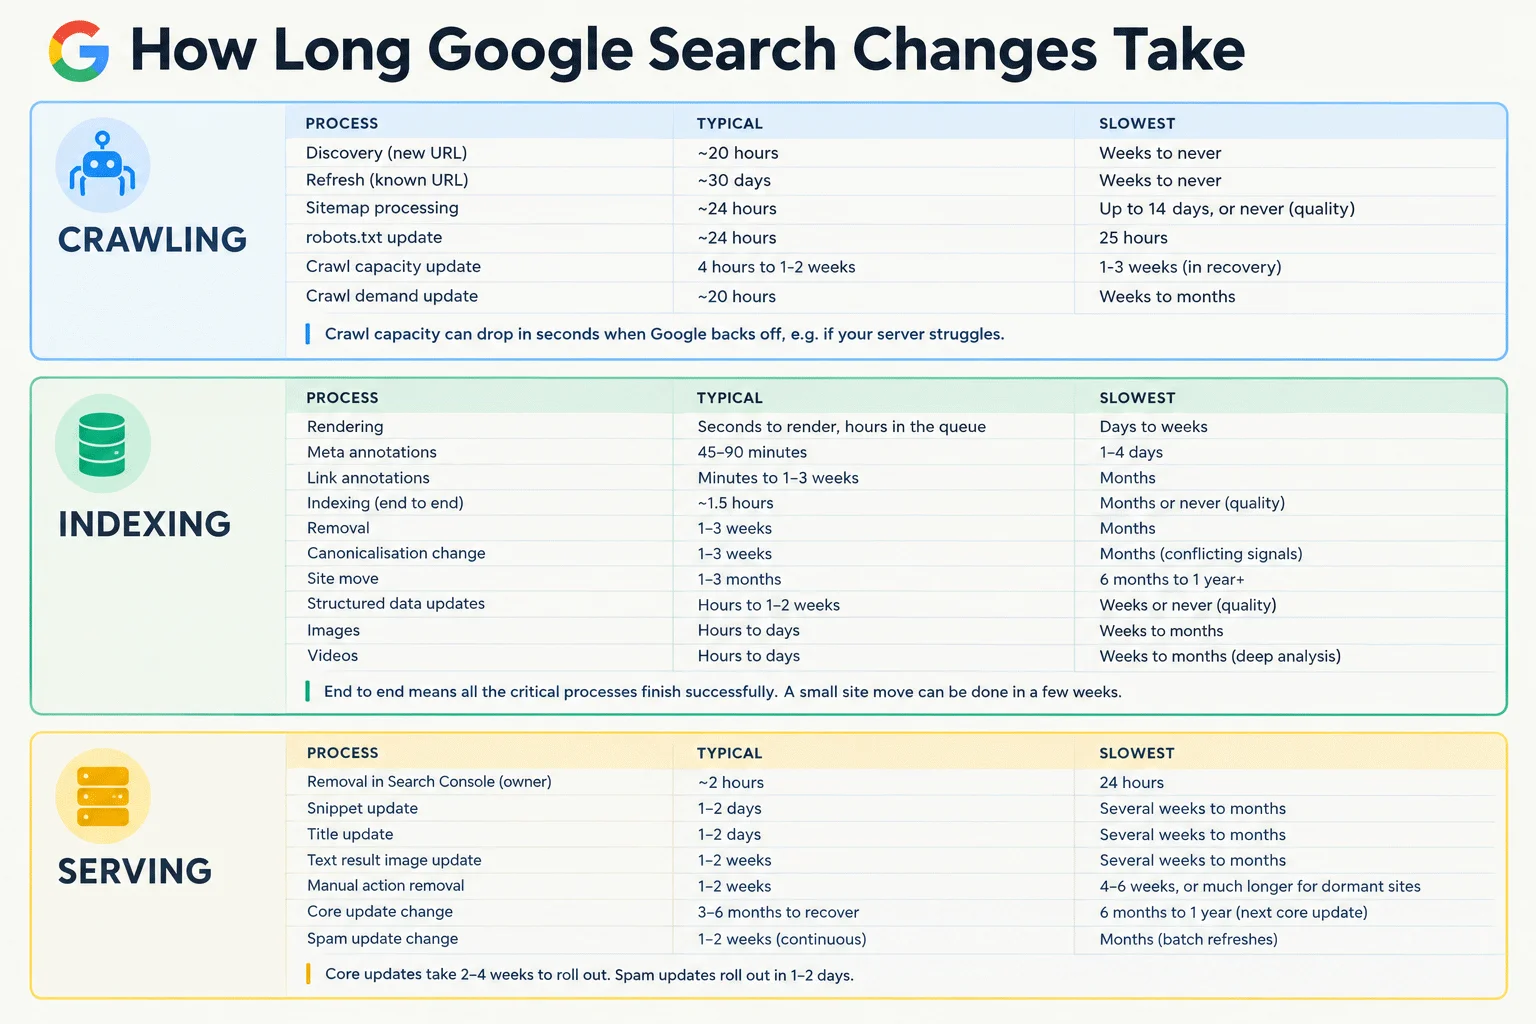
Google chyba po raz pierwszy pokazało tak szczegółowe dane dotyczące tego, ile czasu zajmują poszczególne procesy związane z wyszukiwaniem i przetwarzaniem stron. To bardzo cenny insight dla wszystkich osób wykonujących pozycjonowanie, ale też dla właścicieli i wydawców.
Zobacz też:
To info z pierwszej ręki od Gary’ego Illyesa, który omówił wszystko podczas wydarzenia Google Search Central Live. Dostaliśmy informacje związane m.in. z czasem crawlowania, renderowania, indeksowania, przetwarzania sitemap, robots.txt, canonicali oraz danych strukturalnych.
Uwzględniono zarówno typowe czasy realizacji, jak i najdłuższe obserwowane wartości. A jako wisienkę na torcie dorzucono też uśrednione widełki pokazujące czas wdrażania core oraz spam update’ów: są to odpowiednio 2-4 tygodnie oraz 1-2 dni.
Wszystkie najważniejsze informacje znajdziecie na poniższej grafice:
5. Google: Ręczna weryfikacja faktów jest niezbędna przed opublikowaniem treści AI
Google mówi wprost: teksty wygenerowane przez AI trzeba zawsze ręcznie sprawdzać.
W dokumentacji dotyczącej korzystania z treści utworzonych za pomocą generatywnej AI pojawił się na ten temat nowy zapis.
Komunikat jest dość mocny, bo podkreślono, że ręczna weryfikacja jest absolutnie „kluczowa” (z ang. „critical”). Powinna ona obejmować sprawdzenie tekstów pod kątem zgodności z faktami, dokładności i wiarygodności.
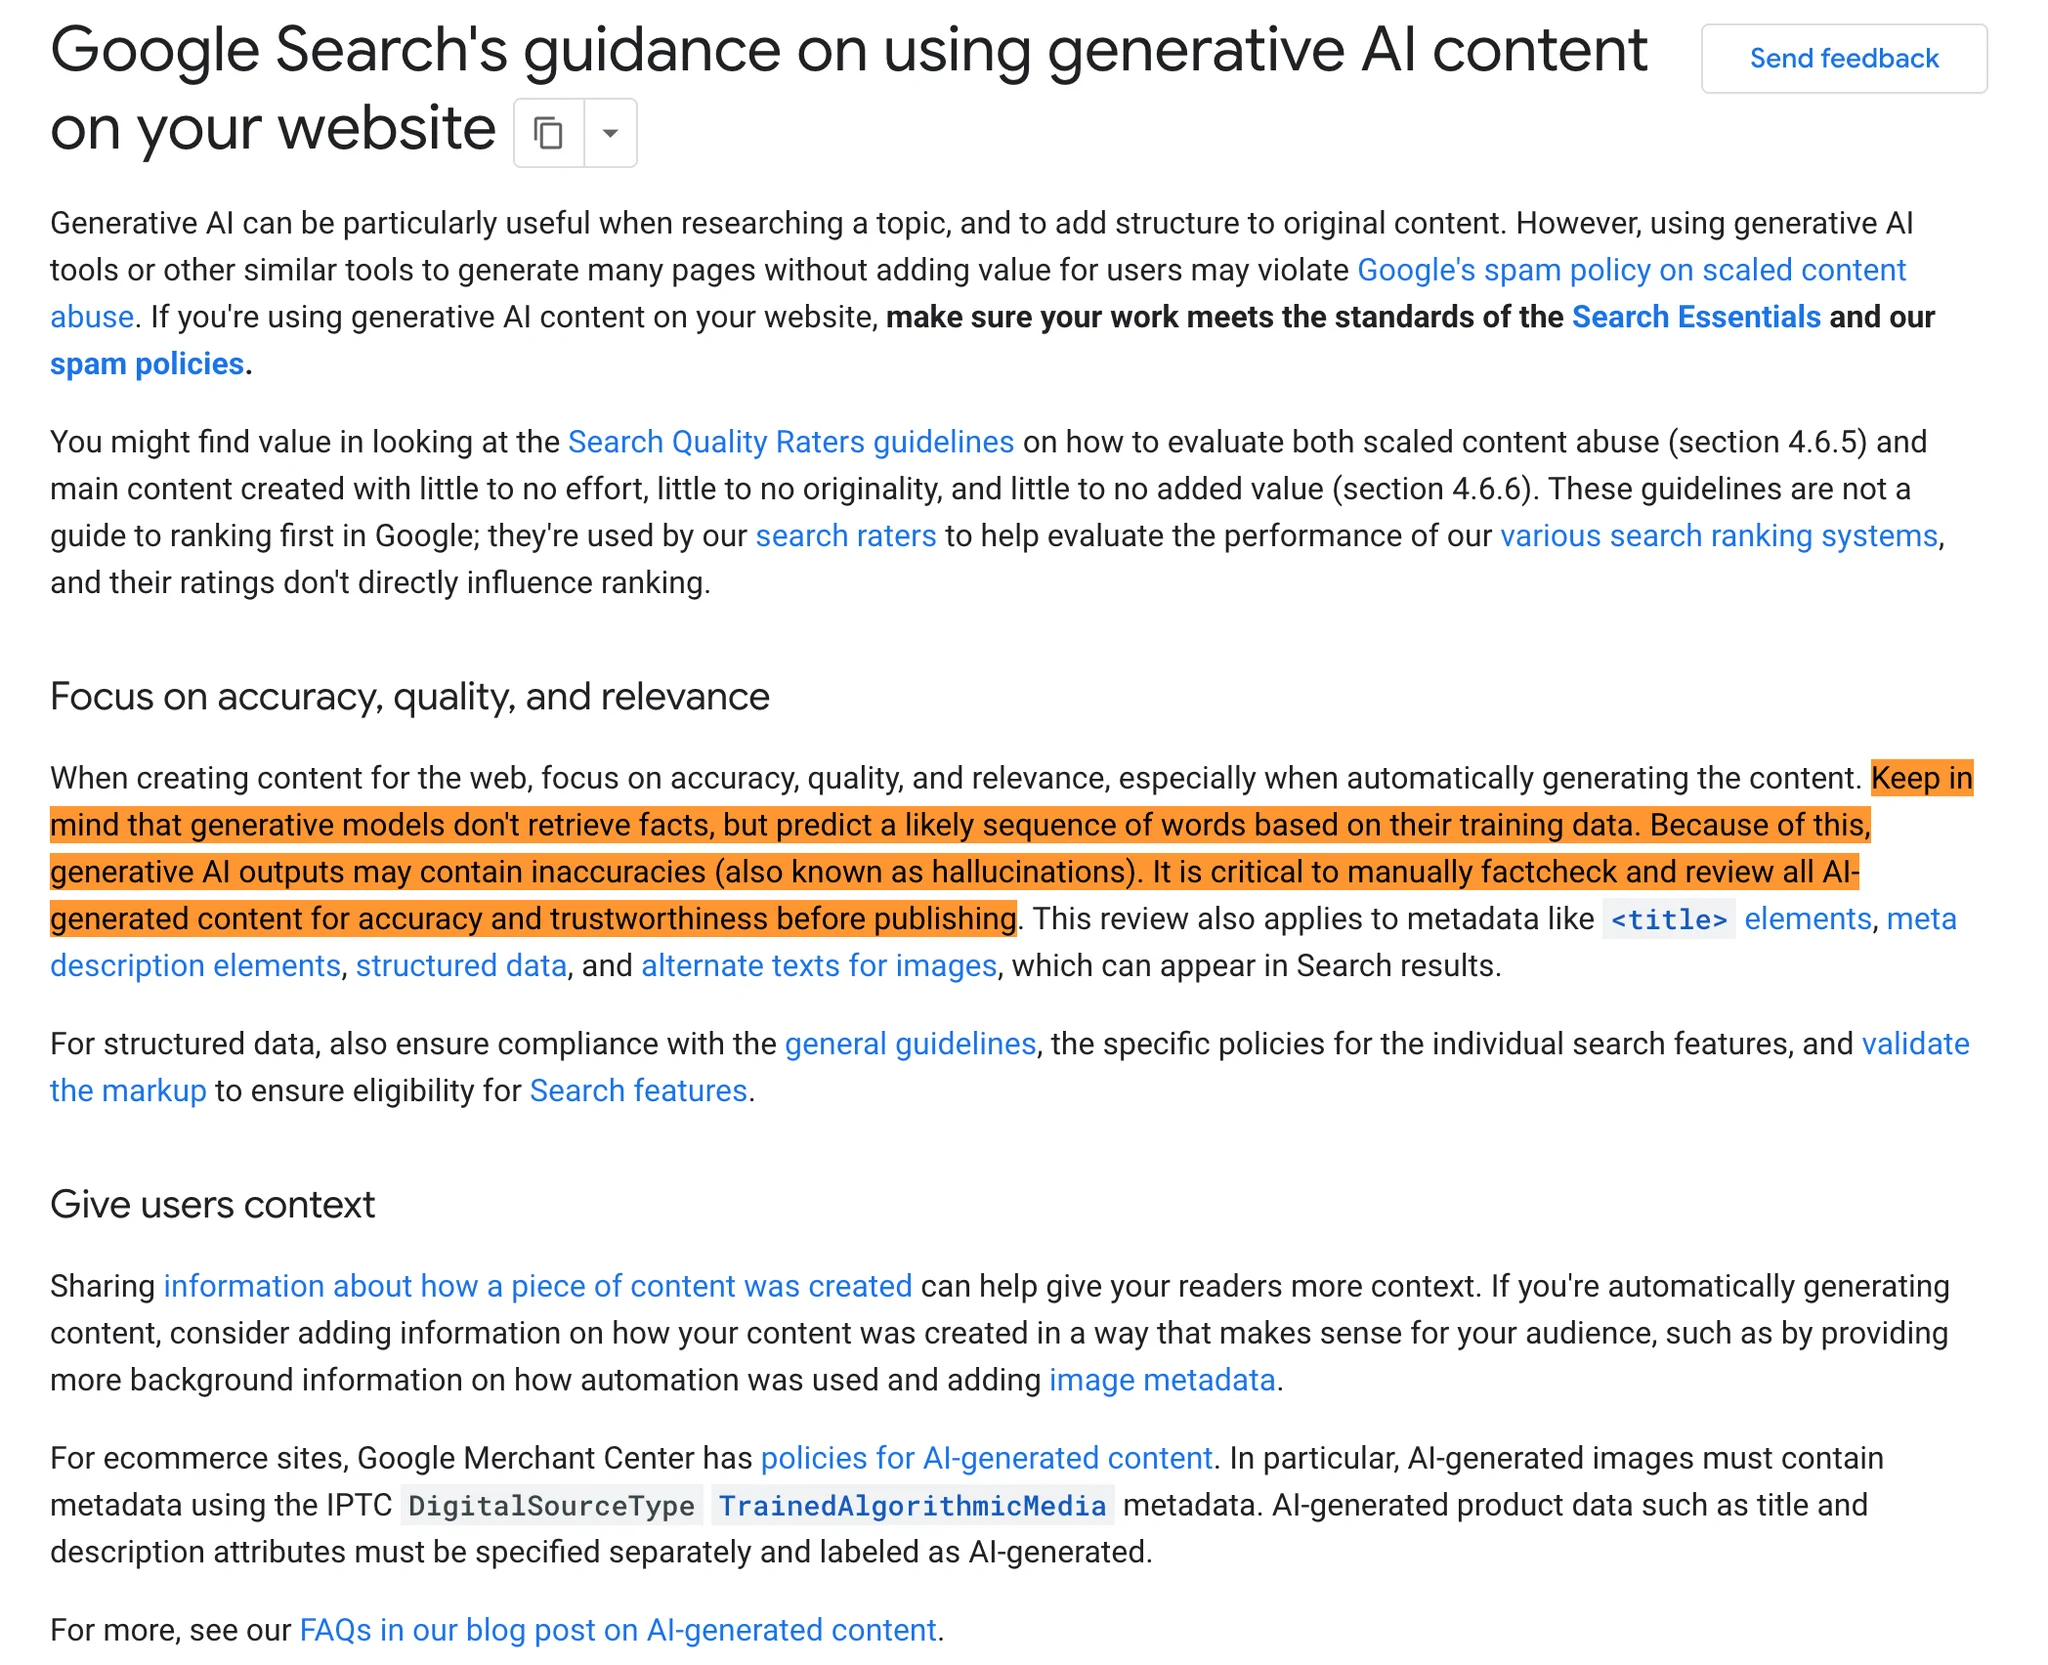
Google już nie sugeruje, ale wręcz namawia, żeby nie próbować maksymalnie automatyzować obsługi contentu i publikować ejajowych śmieci bez żadnej kontroli człowieka – to się może źle skończyć dla widoczności strony.
6. Shopify otwiera checkout dla agentów zakupowych
Agentic commerce zbliża się wielkimi krokami – Shopify rozszerza możliwości agentów AI o sam proces checkoutu, czyli finalizacji zakupu.
Do tej pory agenci działający w przeglądarce mogli m.in. wyszukiwać produkty, dodawać je do koszyka czy przechodzić do kasy. Teraz mogą również odczytywać informacje z aktywnej strony zamówienia, aktualizować dane, korzystać z kodów rabatowych i ostatecznie złożyć zamówienie.
Jednak zanim agent sam wszystko dopnie, powinien dostać wyraźną zgodę użytkownika. Musi pokazać podsumowanie zamówienia i jego całkowitą wartość oraz uzyskać zgodę. Jeśli cena się zmieni, potrzebna będzie kolejna akceptacja.
Agent nie może też samodzielnie wpisać nowych danych karty płatniczej, a w sytuacjach wymagających dodatkowej autoryzacji, np. 3D Secure, kontrolę przejmuje człowiek.
Od strony technicznej Shopify wykorzystuje WebMCP, które pozwala stronie udostępniać agentowi konkretne funkcje. Ma im to ułatwiać wykonywanie zadań w bardziej przewidywalny sposób.
Technologia wciąż jest na wczesnym etapie, a jej działanie zależy od wsparcia po stronie przeglądarki oraz samego agenta.
Całość odbywa się w przeglądarce użytkownika, w ramach istniejącej sesji zakupowej. Shopify twierdzi, że sprzedawcy nie muszą robić dodatkowej konfiguracji, żeby korzystać z tych narzędzi.
7. Odpowiedzi AI najczęściej kierują użytkowników do dużych sieciówek
AI może znać mały sklep, cytować jego stronę i nawet wyświetlić do niej link, ale to wcale nie znaczy, że właśnie ten sklep poleci klientowi.
Tak wynika z badania Vaer AI przeprowadzonego na zlecenie Lightspeed, w którym przeanalizowano około 460 tys. odpowiedzi w LLM-ach.
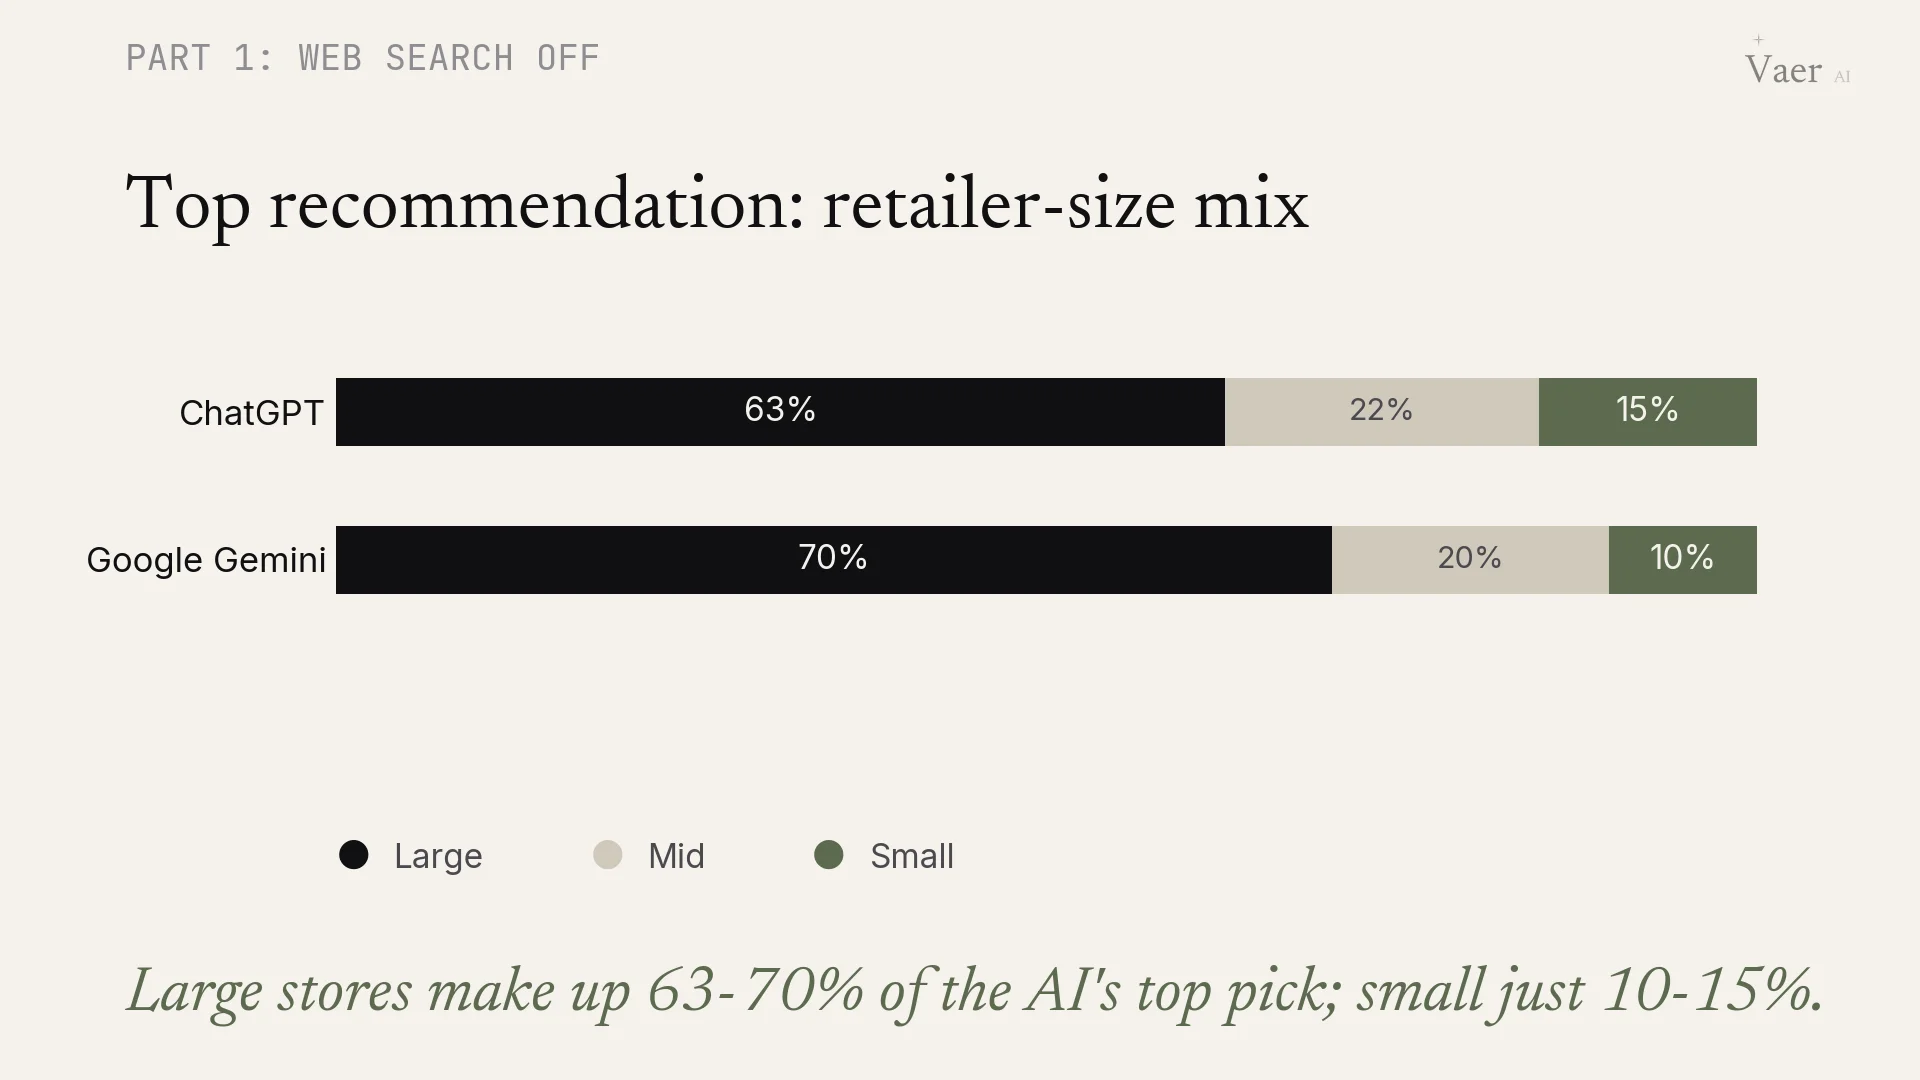
- AI wyraźnie faworyzuje duże sieci handlowe – bez dostępu do wyszukiwania modele wskazywały dużego sprzedawcę w 63-70% przypadków, a mały lub lokalny sklep tylko ok. 1 na 10 razy.
- Gdy model miał wybrać jedną z dwóch firm bez informacji o ich wielkości, wskazywał większy sklep w 90-94% przypadków.
- Przy wyszukiwaniu na żywo duże sieci sklepów pojawiały się w 46-58% czołowych pozycji.
- Lokalne sklepy wyświetlały się tylko w 17% odpowiedzi AI Overviews w pytaniach z kategorii elekroniki.
Warto wiedzieć
W badaniu podano przykład odpowiedzi ChatGPT, w której wśród sześciu źródeł znalazły się trzy małe sklepy papiernicze, ale jako pierwszą rekomendację model podał Staples, czyli branżowego giganta. Duże sieci wyświetlały się jako główne rekomendacje około 2,5 razy częściej niż małe sklepy.
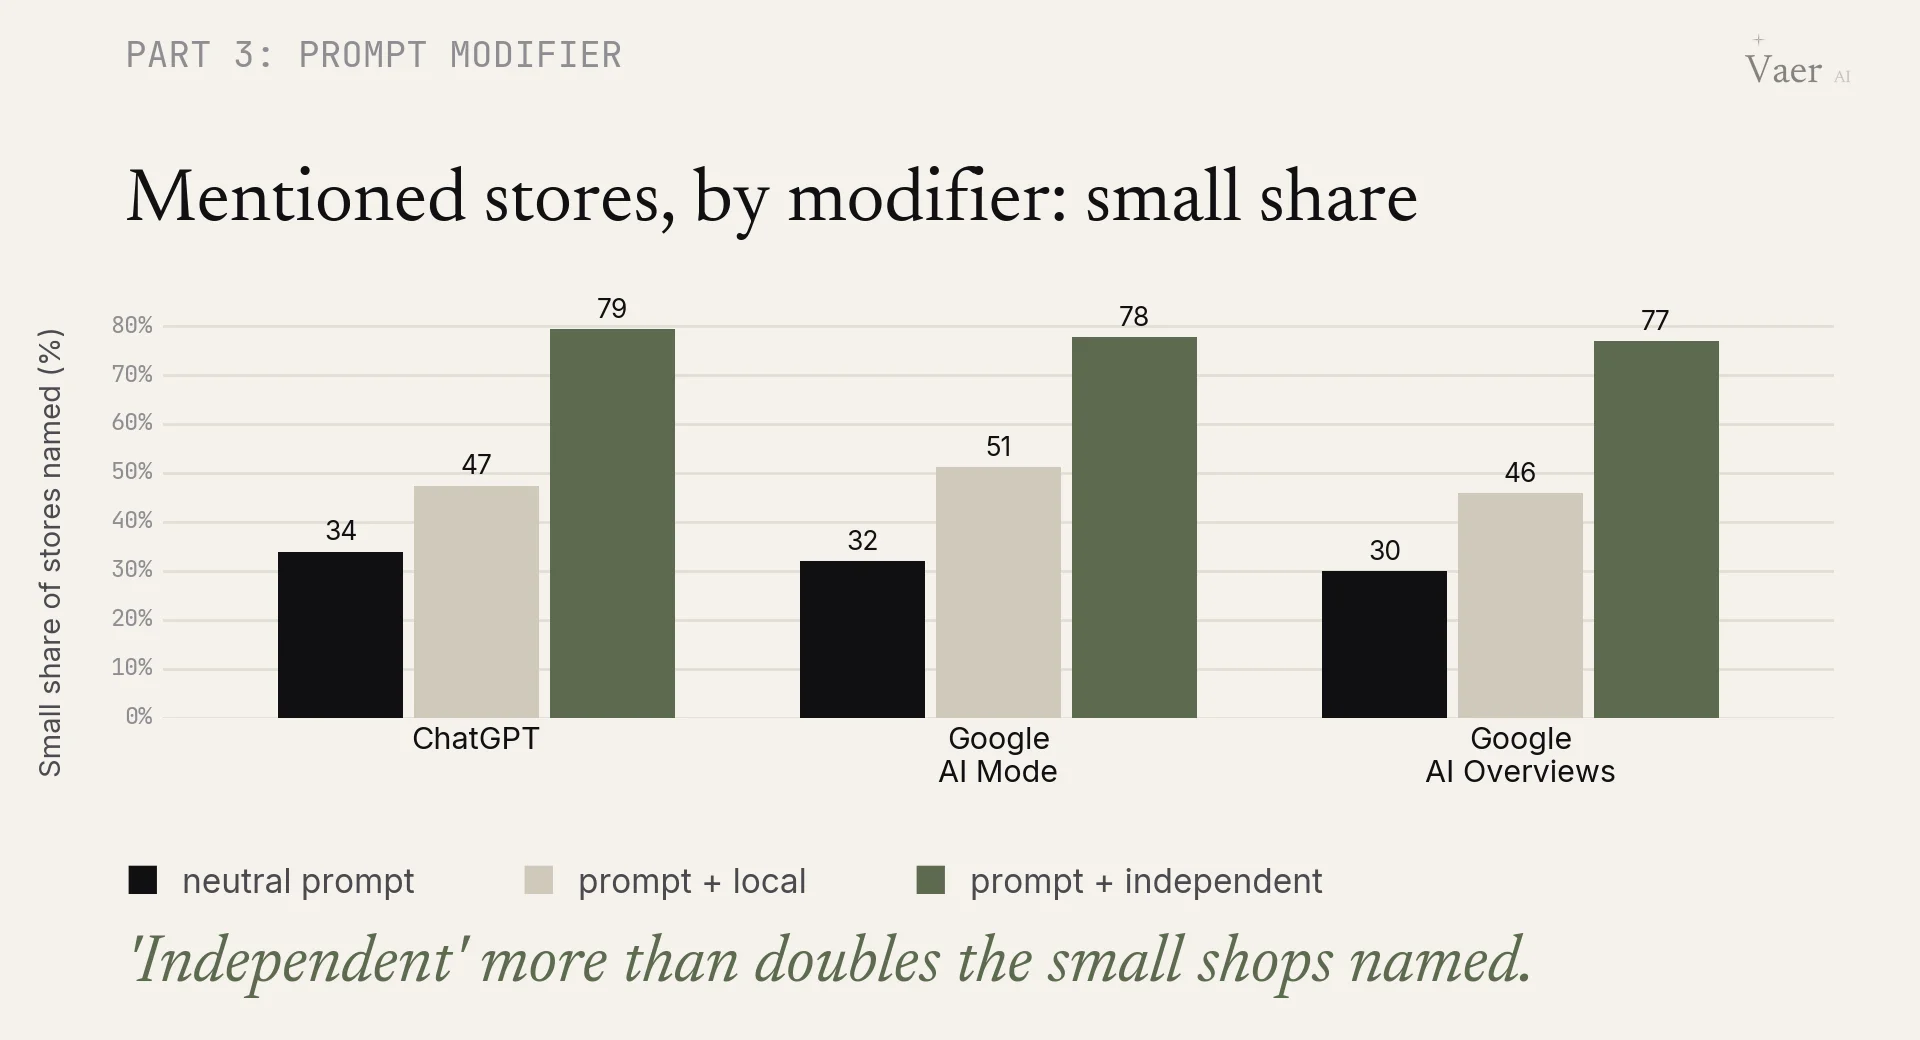
Co ciekawe, gdy w promptach pojawiało się słowo „niezależny”, udział małych i lokalnych sklepów w rekomendacjach wzrastał do prawie 80%. Samo określenie „lokalny” działało słabiej, bo AI może uznać za lokalną również placówkę dużej sieci.
Badanie nie pokazuje, ile rzeczywistych zakupów wygenerowały poszczególne rekomendacje. Mamy tutaj informacje przede wszystkim o widoczności i sposobie polecania sklepów przez AI, a nie o bezpośrednim wpływie na sprzedaż.
8. Wrzuć selfie do ChataGPT i… sprawdź ubrania w wirtualnej przymierzalni
OpenAI uruchamia funkcję wirtualnego przymierzania ubrań i akcesoriów, dzięki której użytkownik może zobaczyć, jak wybrany produkt będzie na nim wyglądać przed zakupem.
Przy kwalifikujących się produktach pojawia się przycisk „Try on”, a po dodaniu lub zrobieniu selfie ChatGPT Images generuje wizualizację z ubraniem.
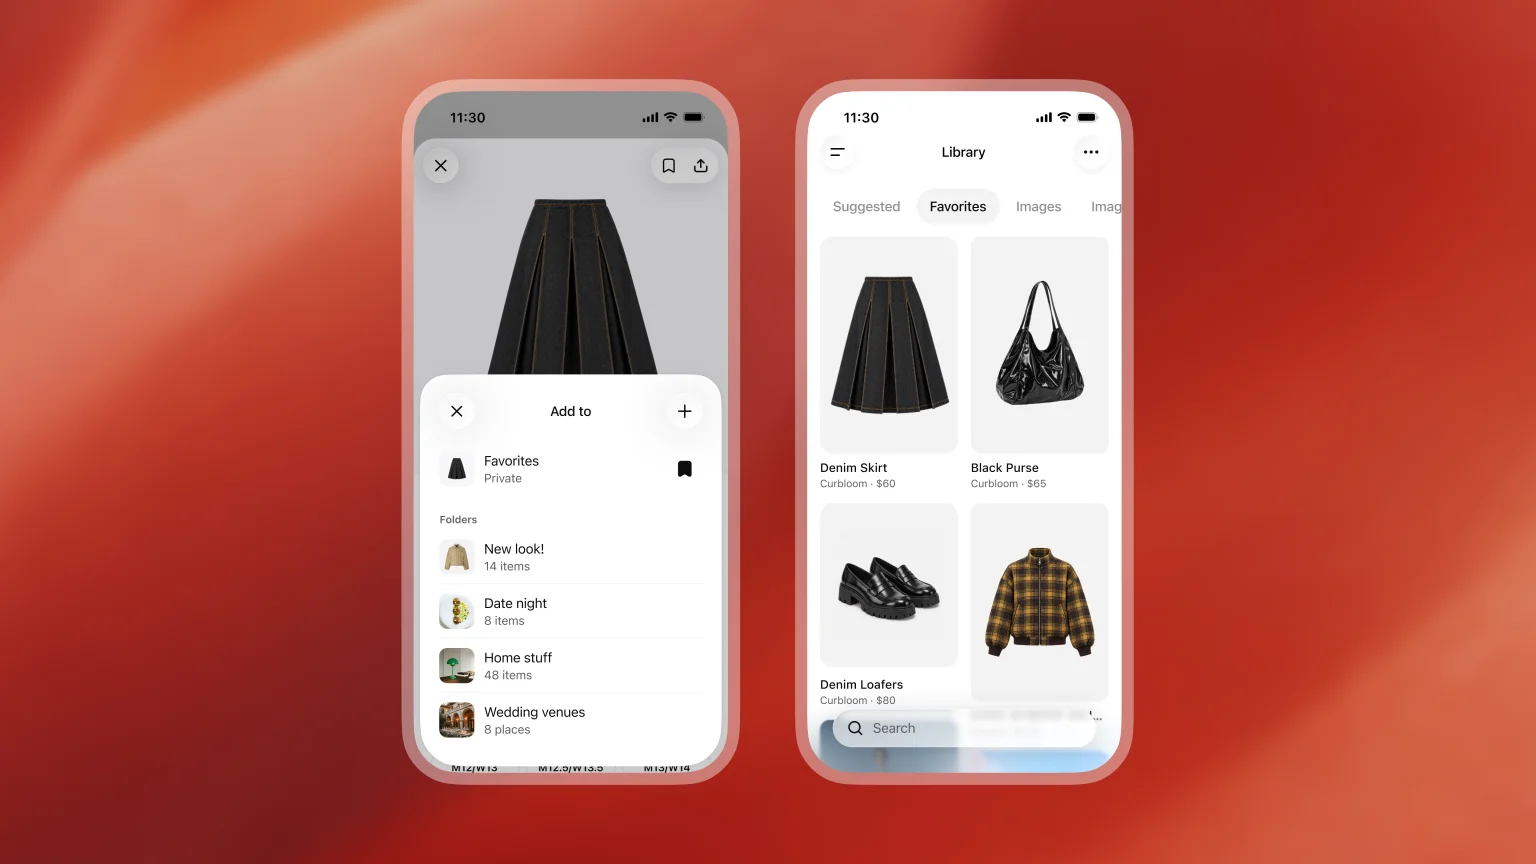
Użytkownik może też po prostu wrzucić zdjęcie albo zrzut ekranu produktu znalezionego gdzie indziej i poprosić o jego wirtualne przymierzenie.
Do tego dochodzi możliwość zapisywania produktów w kategorii ulubionych oraz organizowania ich w folderach w bibliotece ChatGPT. Funkcje działają zarówno na urządzeniach mobilnych, jak i w wersji webowej.
Trzeba jednak pamiętać, że wirtualne przymierzanie to przede wszystkim narzędzie do wizualizacji. Wygenerowany obraz może nie odwzorowywać dokładnie ani sylwetki użytkownika, ani samego produktu, więc nie zagwarantuje odpowiedniego dopasowania. Jest to raczej bajer.
Autor artykułu

Szymon Anioł
Szymon tworzy SEO Newsy i redaguje artykuły ekspertów na naszym blogu. Pisanie do internetu to dla niego czysta frajda, zwłaszcza gdy może wykazać się kreatywnością. Interesuje się neuro- i psychomarketingiem. Po godzinach miłośnik dobrej muzyki, filmów i podróży.