Google udostępnia najnowsze modele z rodziny Gemini – 3.8 Live oraz 3.8 Extended Thinking. W Claude pojawiają się dwie nowości: integracja Cowork z chatem oraz funkcja Claude Code Projects. Wikipedia jako preferowane źródło w Google, czyli lek na spadek ruchu. Wygodne zarządzanie dostępami botów AI w Cloudflare dzięki Bot Preference Sync. Poza tym: aktualizacje profili wydawców w Google, NotebookLM a parasite SEO, a także podsumowania AI w Google Discover.
1. Premiera modeli Google Gemini 3.8 Live i Extended Thinking
Google nie zatrzymuje się z rozwojem modeli z rodziny Gemini. Firma zaprezentowała Gemini 3.8 Live oraz Gemini 3.8 Live Extended Thinking – modele stworzone z myślą o naturalnych rozmowach głosowych, ale też realizowaniu bardziej złożonych poleceń.
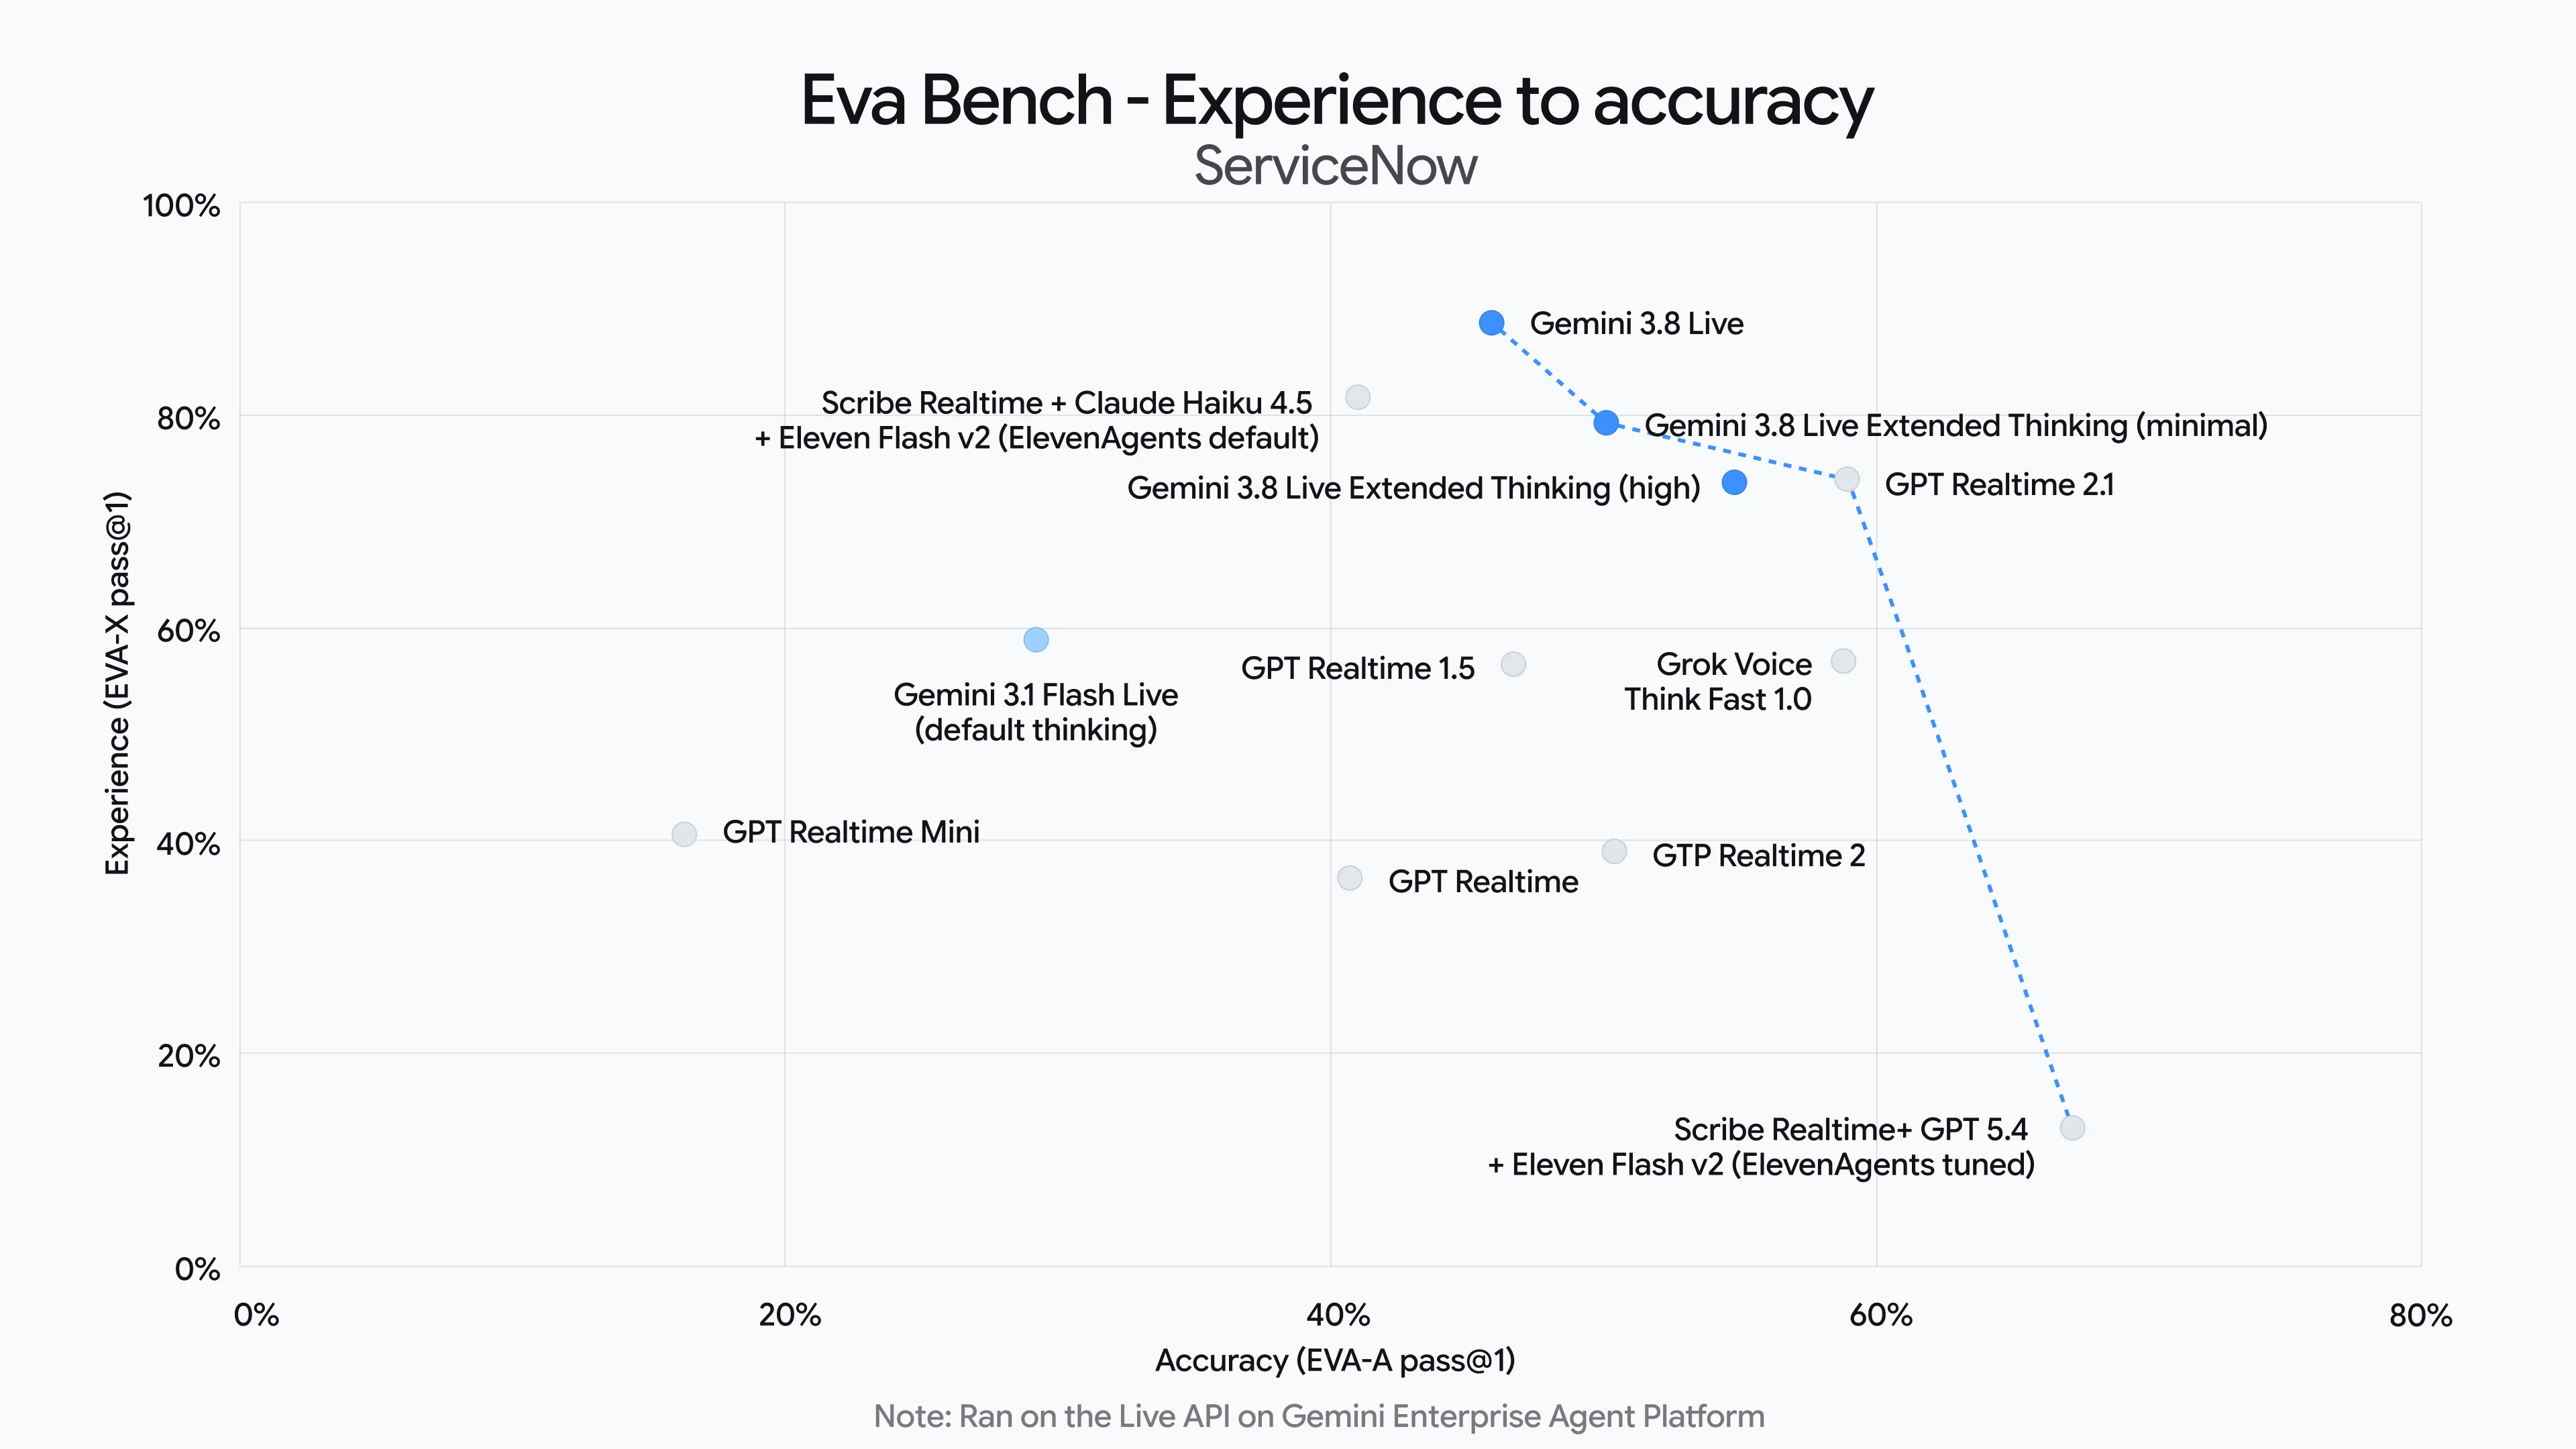
Gemini 3.8 Live
Potrafi prowadzić rozmowę w czasie rzeczywistym, analizować obraz z kamery i korzystać z narzędzi oraz API bez przerywania konwersacji. Można więc z nim rozmawiać, a jednocześnie zlecić mu wykonanie konkretnej operacji.
Model obsługuje 97 języków i może automatycznie przełączać się między nimi podczas rozmowy.
Gemini 3.8 Live Extended Thinking
Może prowadzić bardziej złożone rozumowanie w tle, podczas gdy użytkownik nadal z nim rozmawia. Potrafi wykonywać wieloetapowe zadania, korzystać z narzędzi, informować o postępach i dopiero na końcu przedstawić rezultat.
Na przykładach widać m.in. tworzenie komponentów React, realizowanie wieloetapowych rezerwacji czy przygotowywanie biznesplanów i materiałów marketingowych.
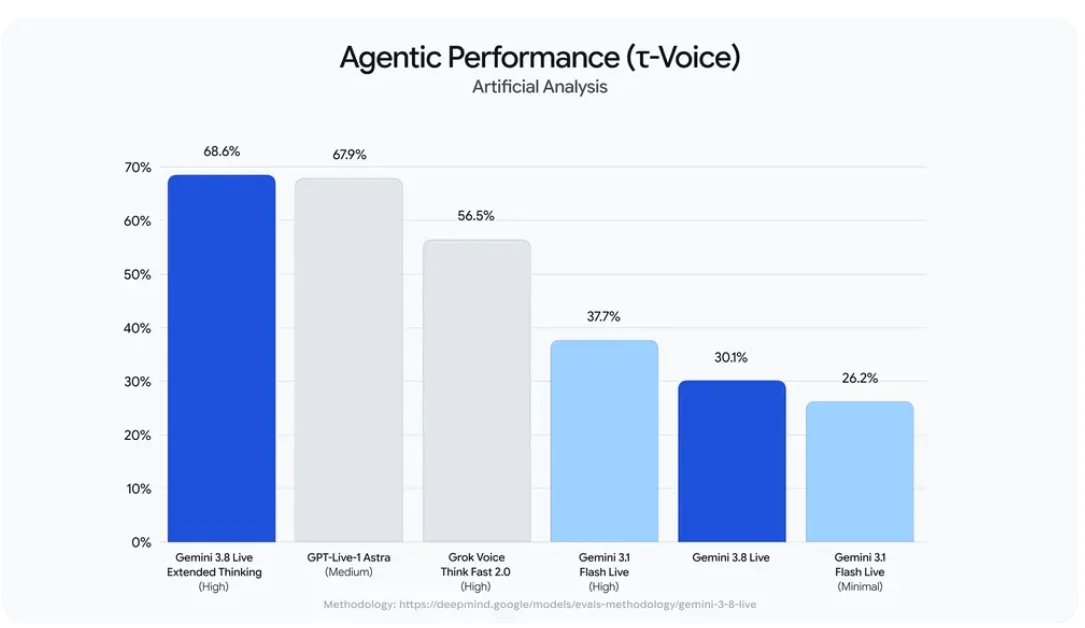
Google oczywiście chwali się wynikami nowych modeli w testach dotyczących jakości rozmowy głosowej i realizacji zadań agentowych. Gemini 3.8 Live Extended Thinking osiągnął m.in. 82,6% w Speech to Speech Quality Index oraz 68,6% w benchmarku τ-Voice.
Standardowy Gemini 3.8 Live ma być z kolei rozwiązaniem nastawionym bardziej na szybkość, skalowanie i niższy koszt.
Gemini Live będzie wykorzystywany m.in. w Search Live, a funkcje Extended Thinking pojawią się w Gemini i Google Workspace.
2. Nowości w Claude: Cowork zintegrowany z chatem oraz funkcja Claude Code Projects
W ostatnich dniach Anthropic ogłosił dwie duże aktualizacje dotyczące swojego flagowego chatbota, których celem jest – mówiąc najprościej – ułatwienie nam życia.
Pierwsza zmiana dotyczy połączenia zwykłego Claude z funkcją Cowork. Użytkownik nie musi już zastanawiać się, czy dane zadanie wymaga klasycznego czatu, czy bardziej zaawansowanego trybu „agentowego”.
Wystarczy, że zacznie rozmowę, a Claude sam dobierze potrzebne funkcje. Jeśli proste pytanie przerodzi się w rozbudowany research, analizę plików, pracę z podłączonymi usługami, przygotowanie dokumentu albo prezentacji, wszystko może odbywać się w ramach tej samej rozmowy.
Anthropic dodaje przy okazji funkcje Claude Docs, Slides i Design do rozmów, a prezentacje można potem eksportować m.in. do PowerPointa i PDF-a.
Cowork w interfejsie chatu będzie początkowo dostępny w planach Claude Pro i Max w wersji webowej, desktopowej i mobilnej. Użytkownicy pakietów Team i Free mają otrzymać go nieco później.
Oprócz tego dostaliśmy nowe narzędzie Claude Code Projects. W wersji beta tego rozwiązania jedna sesja Claude może pełnić funkcję koordynatora i rozdzielać pracę pomiędzy inne sesje AI. Czyli jeden Claude zarządza innymi „Claude’ami”.
Poszczególne zadania działają jako osobne wątki, mogą pracować równolegle, korzystać ze wspólnej pamięci i plików, a użytkownik może obserwować ich postępy i w razie potrzeby ingerować.
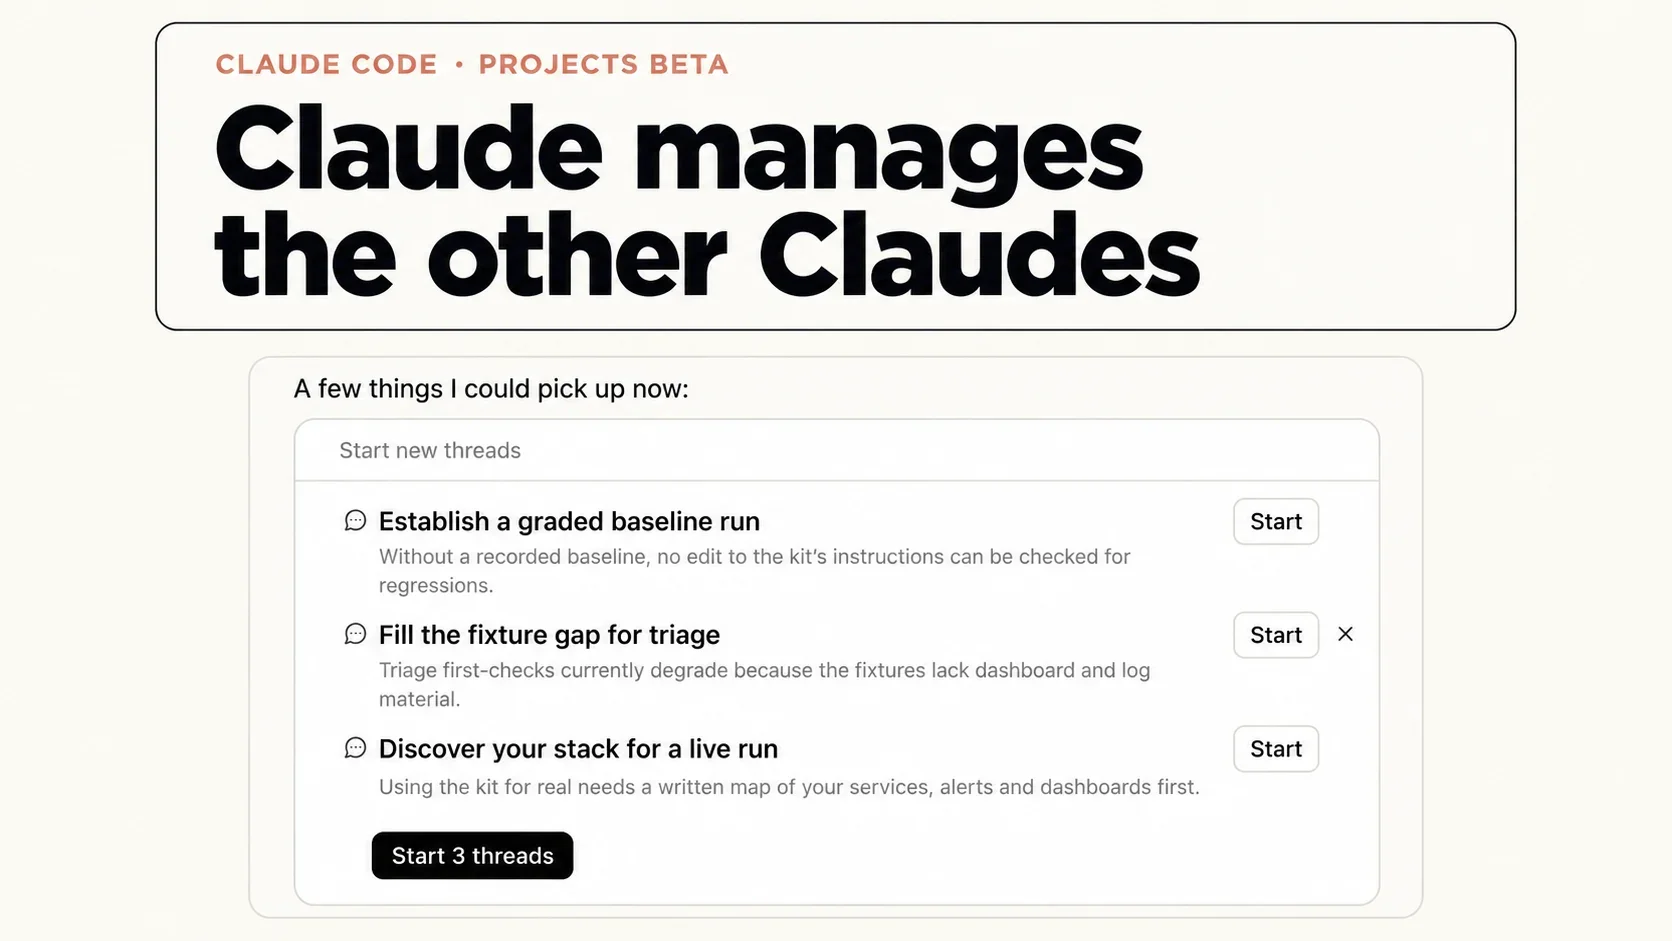
Co ciekawe, rozwiązanie może pracować również na przesłanych dokumentach, więc nie ogranicza się wyłącznie do programowania.
Projekty w becie są przypisane do jednego użytkownika, nie można jeszcze udostępniać ich współpracownikom, a równoległe sesje nadal korzystają z limitów danego planu.
Czy to koniec podejścia human-in-the-loop? Niekoniecznie – ktoś przecież musi sprawdzić wyniki pracy poszczególnych sesji i upewnić się, że analizowały dane według tych samych założeń. Wspólna pamięć pomaga przekazywać kontekst, ale nie gwarantuje automatycznie spójności rezultatów.
3. Wikipedia traci ruch i chce przetestować funkcję Preferred sources w Google
Wikipedia zamierza sprawdzić, czy funkcja Preferowane źródła pomoże jej odzyskać część ruchu traconego z wyszukiwarki.
Według najświeższych danych Wikipedia odnotowała około 138 mln mniej przejść z Google w ostatnim tygodniu sierpnia i pierwszym tygodniu września w porównaniu z analogicznym okresem rok wcześniej.
Spadek ruchu z wyszukiwarki jest więc dla serwisu realnym problemem – mówimy tu o wyniku gorszym aż o 17%.
Jeśli użytkownicy wskażą Wikipedię jako ulubione źródło, Google może częściej pokazywać jej treści w wynikach wyszukiwania oraz w funkcjach opartych na AI – AIO czy AI Mode.
Wikimedia chce przetestować, czy taki mechanizm przełoży się na częstsze powroty użytkowników na samą Wikipedię.
Warto wiedzieć
Wikimedia Foundation to organizacja non-profit odpowiedzialna za działanie Wikipedii, jej infrastrukturę i rozwój.
Celem fundacji jest nie tylko odzyskanie ruchu, ale też sprawdzenie, czy jednorazową wizytę z wyszukiwarki można zamienić w bardziej trwałą relację z użytkownikiem. Zamiast liczyć na kolejne przypadkowe kliknięcie, Wikipedia chce być świadomie wybieranym źródłem informacji.
Całe przedsięwzięcie ma się rozpocząć pod koniec września lub na początku października i potrwać około dwa tygodnie.
4. Cloudflare pozwoli zdecydować, jak udostępniamy stronę botom AI
Cloudflare chce uprościć właścicielom stron zarządzanie crawlerami AI. Firma uruchomiła funkcję Bot Preference Sync, która pozwala ustawić preferencje dotyczące botów w panelu Cloudflare, a następnie automatycznie przenieść je do pliku robots.txt.
A to oznacza, że nie trzeba będzie za każdym razem ręcznie aktualizować listy crawlerów.
Zdecydowanie najciekawszą opcją jest możliwość rozdzielenia dostępu do treści: dla botów od wyszukiwania oraz botów używanych do trenowania modeli AI.
Chodzi tutaj o rozwiązanie Disallow AI Training, które pozwala zablokować używanie treści do trenowania modeli, jednocześnie pozostawiając dostęp crawlerom wykorzystywanym przez wyszukiwarki.
Zobacz też:
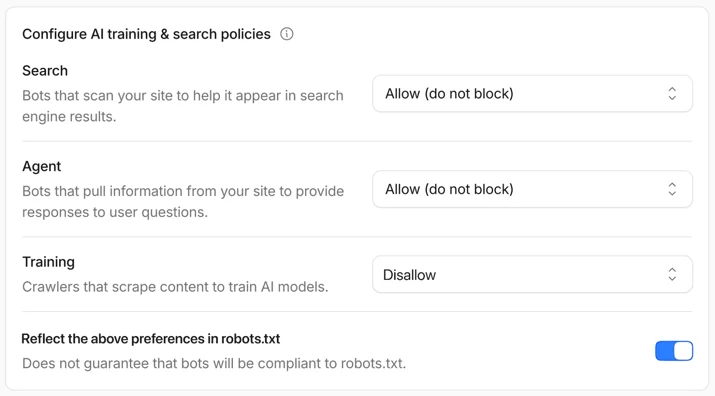
Trzeba jednak uważać, bo poszczególne firmy korzystają z różnych botów do różnych celów, np.:
- ChatGPT – OAI-SearchBot odpowiada za wyszukiwanie w ChatGPT, natomiast GPTBot jest wykorzystywany w kontekście treningu modeli. Można więc dopuścić pierwszy z nich, a drugiego zablokować.
- Google – Google-Extended służy do kontrolowania określonych zastosowań treści przez modele Gemini (trenowanie, grounding), ale jego zablokowanie nie wyłącza strony z klasycznego wyszukiwania w Google. Nie jest też prostym przełącznikiem na zasadzie „wyłącz moją stronę z AI Overviews”.
Warto wiedzieć
Samo zezwolenie na crawling dla botów AI nie oznacza oczywiście, że strona automatycznie trafi do odpowiedzi w ChatGPT, Google czy Claude. A to, czy na Twoją stronę wchodzą crawlery i zaciągają z niej treści, możesz sprawdzić za darmo w naszym narzędziu Agent Monitor.
Cloudflare może więc zautomatyzować techniczną część zarządzania robots.txt, ale nie podejmie decyzji za właścicieli stron ani specjalistów od pozycjonowania, komu i w jakim celu chcą udostępniać treści.
Jeśli potrzebujemy prostego ustawienia typu „tak dla wyszukiwania, nie dla treningu”, taka automatyzacja jest super wygodna. Jednak przy bardziej szczegółowych wyjątkach nadal trzeba ręcznie zarządzać regułami i wiedzieć, za co odpowiada konkretny crawler.
5. Google aktualizuje profile wydawców w wyszukiwarce
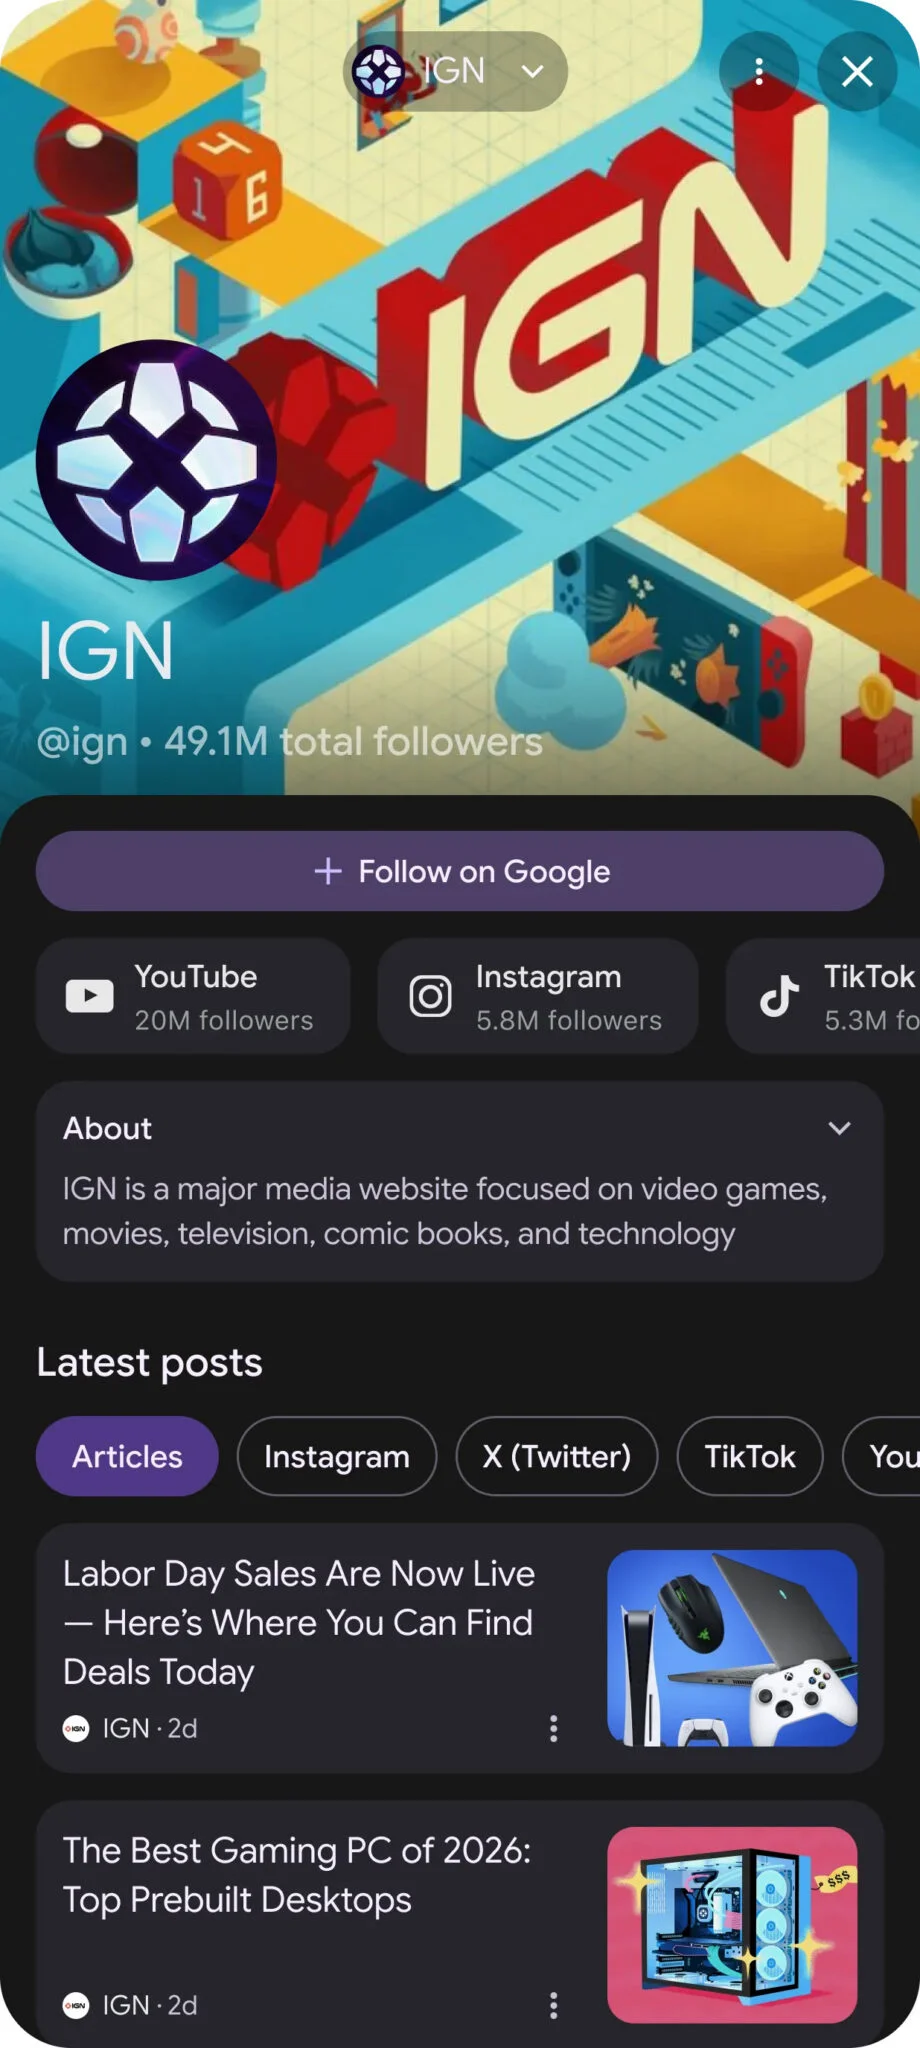
Google wprowadziło kilka zmian w Search Profiles, czyli profilach wydawców widocznych w wynikach wyszukiwania i innych powierzchniach Google.
Najważniejszą informacją z punktu widzenia wydawców jest obniżenie wymagań dotyczących liczby obserwujących.
Początkowo do utworzenia profilu potrzebne było 100 tys. obserwujących w serwisach takich jak YouTube, Instagram, X czy TikTok. Potem obniżono wymagania do 35 tys. a obecnie próg wynosi 10 tys., więc z rozwiązania może skorzystać znacznie więcej twórców i wydawców.
Jedno konto Google może teraz obsługiwać kilka profili, także dla różnych submarek (wcześniej każdy profil wymagał osobnego konta Google).
Odświeżono również wygląd profili, przede wszystkim sposób prezentowania artykułów. Zoptymalizowano miniatury zdjęć i zwiększono długość wyświetlanych nagłówków, żeby treści były łatwiejsze do znalezienia i przejrzenia.
6. NotebookLM (Gemini Notebook) wykorzystywany w parasite SEO
Google NotebookLM, a dokładnie publiczne notatniki tworzone w tej usłudze, zaczynają być bardzo sprytnie wykorzystywane w nie-do-końca-dobrym SEO.
Trafiłem na opisy przypadków, w których publiczne notebooki zaczęły pojawiać się w wynikach wyszukiwania, a przynajmniej jeden z nich został wskazany jako… źródło w AI Overviews.
Wśród przykładów są materiały promujące kody rabatowe, linki afiliacyjne czy różnego rodzaju usługi. Jeden z notatników dotyczył kuponów na rowery elektryczne i prowadził użytkowników do konkretnego sklepu za pomocą linku polecającego.
Gdzie w tym wszystkim pojawia się parasite SEO? Mechanizm jest prosty:
- Ktoś wrzuca swoją treść do NotebookLM (czyli na domenie Google).
- Tworzy publiczny notatnik, który zaczyna pojawiać się w wynikach wyszukiwania.
- Łapie fajny zasięg, bo treść wyświetla się większej liczbie użytkowników (i w teorii nie musi budować widoczności własnej strony).
Co ciekawe, Google nie traktuje automatycznie takich materiałów jako spamu. Może oczywiście ograniczyć indeksowanie publicznych notatników – ale wtedy z wyszukiwarki zniknęłyby również legalne i wartościowe materiały.
7. Testy funkcji Odkryj więcej w Google Discover
Google testuje w Discover nową funkcję „Dive deeper”, która ma ułatwić użytkownikom poznawanie konkretnego tematu bez potrzeby przechodzenia od razu na stronę wydawcy (brzmi znajomo?).
Po kliknięciu odpowiedniej karty Google pokazuje krótkie podsumowanie wygenerowane przez AI oraz linki do powiązanych artykułów, materiałów społecznościowych i oryginalnych źródeł.
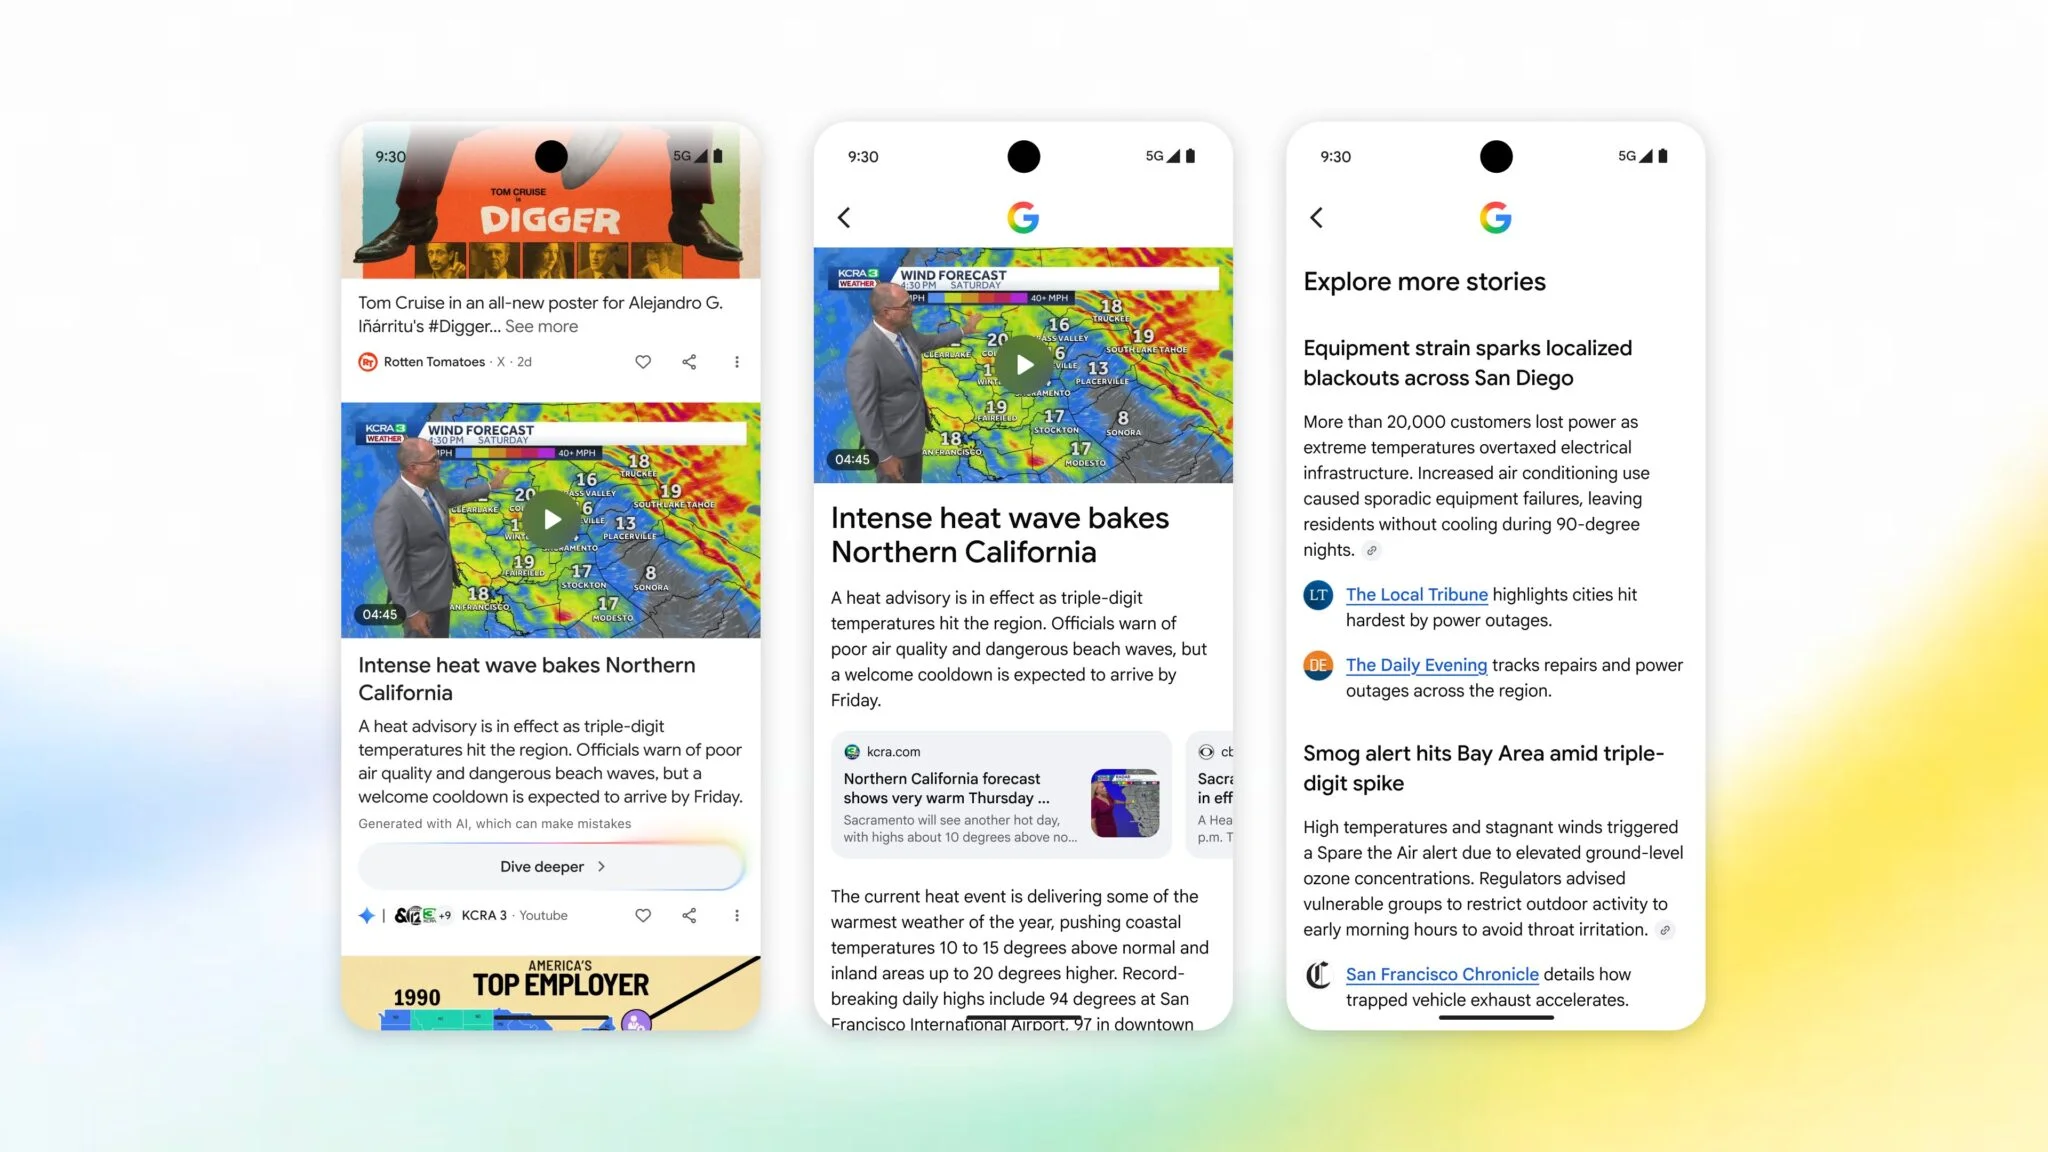
Na razie rozwiązanie jest testowane przy materiałach wideo, ale Google zapowiada kolejne eksperymenty z funkcją i jej wyglądem.
Jak już się pewnie domyślacie, na horyzoncie pojawia się potencjalny problem dla wydawców. Jeśli użytkownik dostanie wystarczająco dużo informacji w Discover, może już nie mieć powodu, żeby kliknąć dalej i przejść do całego artykułu.
Nawet gdy Google pokaże później linki do źródeł, część ruchu może zostać zatrzymana na poziomie samego feedu.
Autor artykułu

Szymon Anioł
Szymon tworzy SEO Newsy i redaguje artykuły ekspertów na naszym blogu. Pisanie do internetu to dla niego czysta frajda, zwłaszcza gdy może wykazać się kreatywnością. Interesuje się neuro- i psychomarketingiem. Po godzinach miłośnik dobrej muzyki, filmów i podróży.