Google sugeruje, żeby w URL-ach używach myślników do rozdzielania wyrazów, Nvidia pokazuje model AI instalowany lokalnie, a AccuRanker mówi o „zatrutych” wynikach wyszukiwania, które wpływają na wyświetlanie złych danych w ich raportach SEO.
W skrócie:
- Aktualizacja dokumentacji dot. tworzenia adresów URL – Google zaleca stosowanie myślników zamiast podkreślników do oddzielania słów w adresach URL.
- Konwersacyjny (i lokalny) model AI od Nvidii – Nemotron 3.5 Bolt E4B pozwala uruchamiać konwersacyjną AI lokalnie przy budżecie pamięci około 4 GB.
- AccuRanker sugeruje, że błędne dane od Google przekłamują wyniki ich narzędzia – poisoned SERPs mogą powodować fałszywe spadki pozycji w raportach SEO.
- S. Pichai twierdzi, że wyszukiwarka zostanie włączona do warstwy „agentowej” – Google rozwija ekosystem AI, w którym agenci będą łączyć wyszukiwanie z innymi usługami i pomagać użytkownikom realizować wieloetapowe zadania.
- Google: Kod HTTP 503 jest kluczowy podczas przestojów strony – podczas krótkiej przerwy technicznej serwer powinien zwracać kod 503, aby poinformować Google o tymczasowej niedostępności i ograniczyć ryzyko problemów z indeksowaniem.
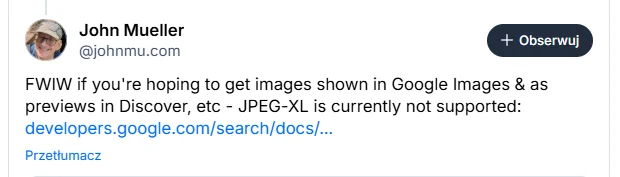
- Wsparcie formatu JPEG XL w wyszukiwarce – co warto wiedzieć? – Google nie obsługuje obecnie JPEG XL w Google Images ani podglądach Discover.
1. Aktualizacja dokumentacji dot. tworzenia adresów URL
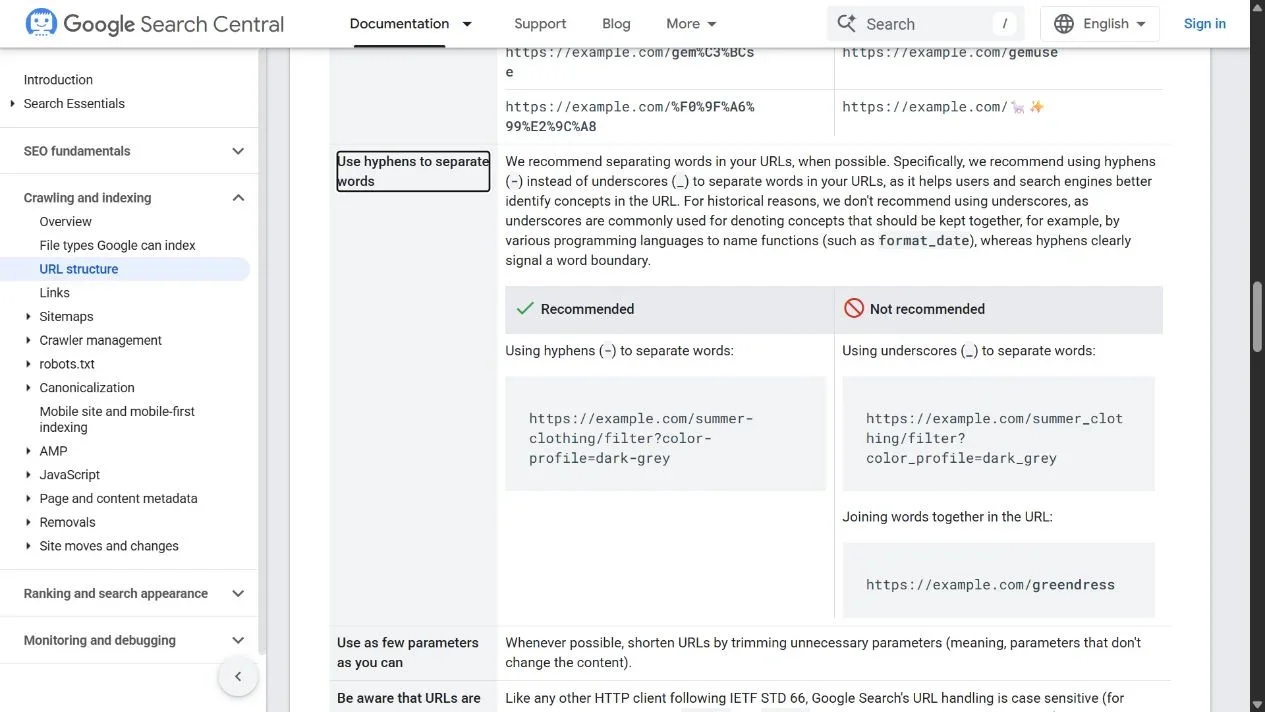
Dlaczego Google preferuje myślniki ( - ) zamiast podkreślników ( _ ) do oddzielania słów w adresach URL? Odpowiedź znajdziemy w odświeżonej dokumentacji.
Chodzi przede wszystkim o to, że myślniki precyzyjnie wskazują granice między poszczególnymi słowami. Natomiast podkreślniki mają historyczne powiązania z programowaniem, gdzie mogą służyć do łączenia elementów nazwy w jedną całość.
Dla przykładu:
/koszulki-meskie/– słowa są oddzielone myślnikiem./koszulki_meskie/– słowa są połączone podkreślnikiem.
Pierwszy zapis wyraźniej pokazuje, że adres składa się z dwóch osobnych słów: „koszulki” i „meskie”. Drugi może sugerować, że oba wyrazy tworzą jeden połączony identyfikator.
Podobna zasada dotyczy parametrów adresów URL, które opisują np. kolor lub materiał produktu.
Ok, mamy takie zalecenia – przy tworzeniu nowych adresów na pewno warto o nich pamiętać. A co, jeśli do tej pory nie korzystaliśmy z myślników? Czy trzeba na siłę to zmieniać?
Niekoniecznie – szczególnie, jeśli wszystko działa poprawnie.
Można co prawda zrobić masową migrację URL-i, ale to się wiąże z odpowiednim przygotowaniem. Trzeba skonfigurować przekierowania 301 lub 308, zaktualizować linki wewnętrzne, adresy kanoniczne i mapę witryny.
Google musi też ponownie przetworzyć zmienione adresy, co może potrwać kilka tygodni (lub dłużej) i zapewne spowoduje przejściowe wahania widoczności.
Nie ma też potrzeby korzystania z narzędzia Change of Address w GSC, jeśli zmieniamy jedynie ścieżki adresów w obrębie tej samej domeny.
2. Konwersacyjny (i lokalny) model AI od Nvidii
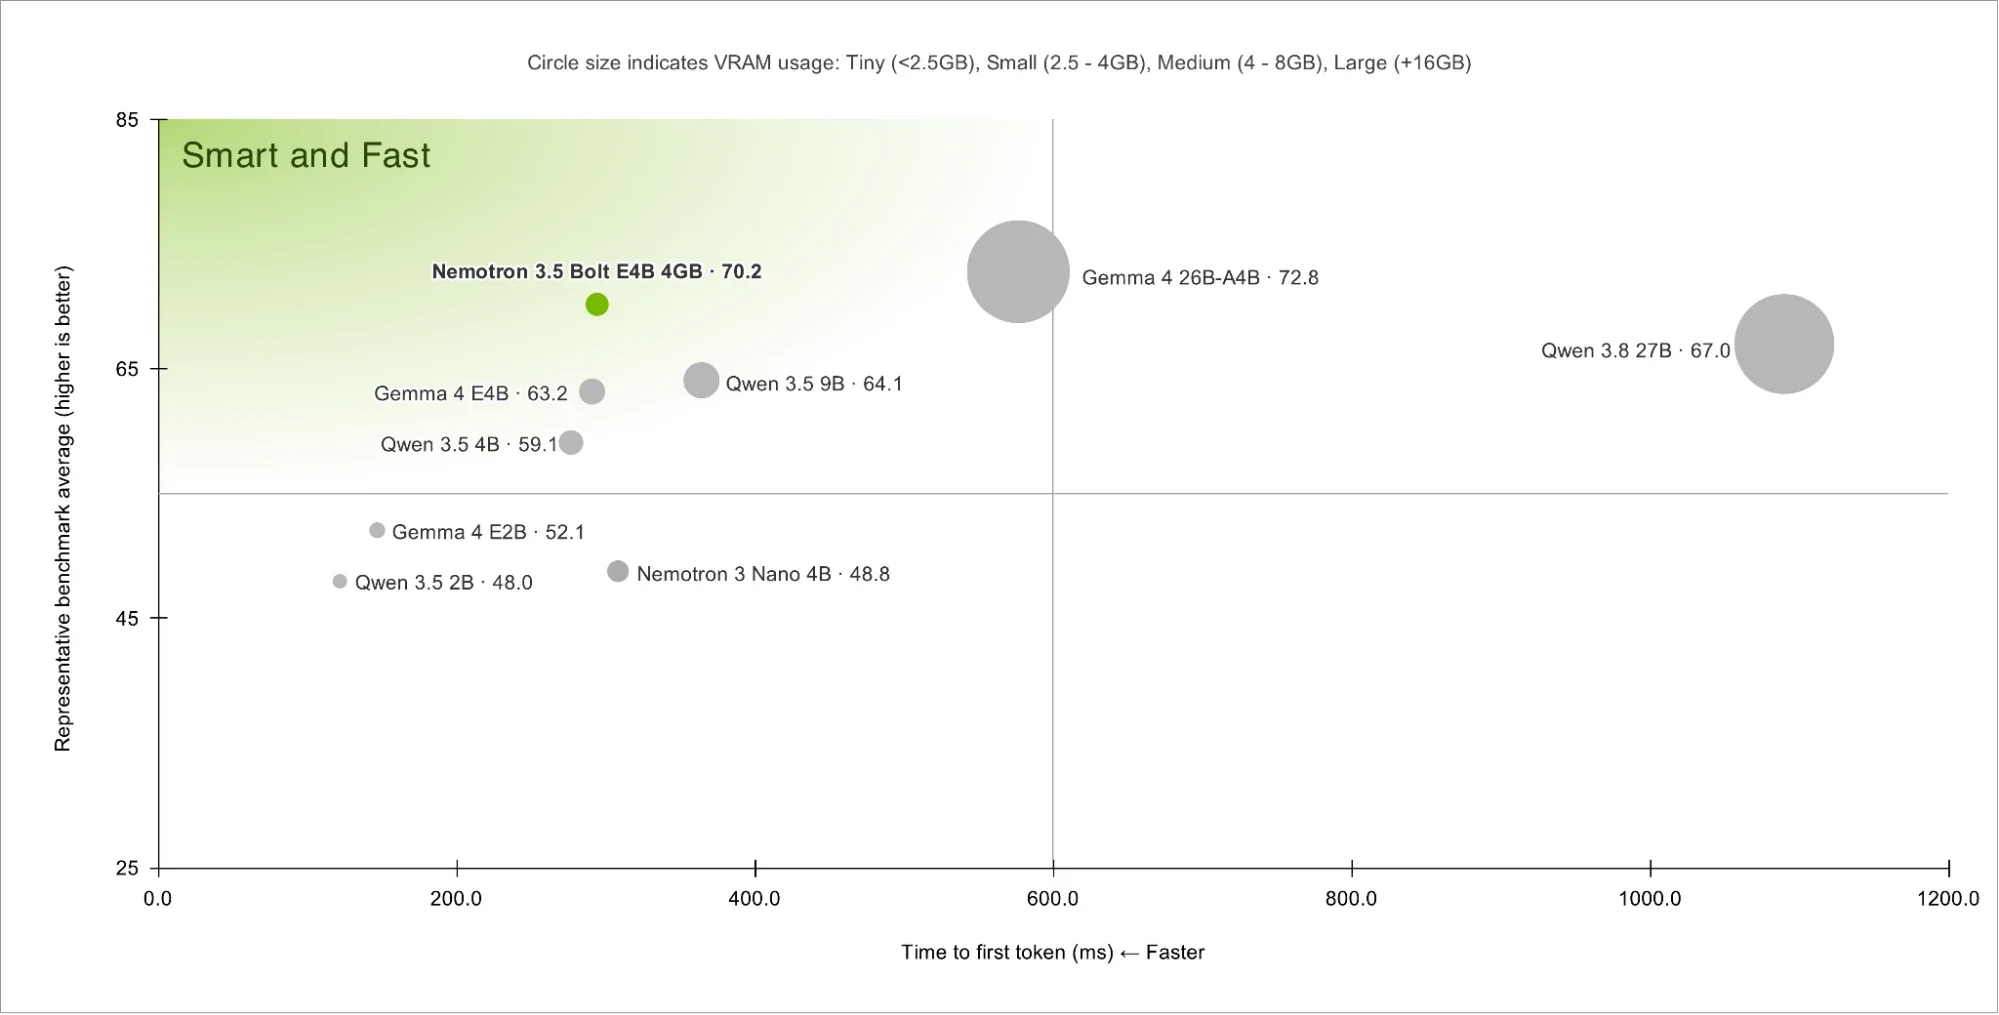
Nvidia zaprezentowała model Nemotron 3.5 Bolt E4B, który ma umożliwiać uruchamianie konwersacyjnej AI lokalnie (na własnym komputerze), przy budżecie pamięci wynoszącym około 4 GB. A to z kolei ma pozwolić ograniczyć jej wykorzystanie.
Model jest przeznaczony m.in. do tworzenia lokalnych asystentów, interaktywnych postaci i aplikacji. Jest w stanie prowadzić wieloetapowe rozmowy oraz wywoływać zewnętrzne narzędzia, dzięki czemu może wykonywać konkretne zadania – oczywiście poza generowaniem tekstu.
Bolt od Nvidii obsługuje kontekst do 64 tys. tokenów, a jego działanie można dostosować do potrzeb aplikacji, na przykład włączając lub wyłączając tryb rozumowania. Do obsługi mowy czy obrazu potrzebne są jednak dodatkowe komponenty, które również zużywają pamięć i moc obliczeniową.
A jak model wypada na tle konkurencji? W teście BFCL-v3 uzyskał 67,3%, a np. taki Qwen 3.5 4B osiągnął 70,6%. Nie jest to więc jakiś spektakularny wynik.
Warto wiedzieć
BFCL-v3 (Berkeley Function-Calling Leaderboard version 3) to benchmark, który sprawdza, czy AI potrafi wybrać odpowiednie narzędzie i prawidłowo go użyć.
Ale jego największą zaletą pozostaje możliwość uruchamiania AI na własnym sprzęcie, bez konieczności przesyłania każdego zapytania do zewnętrznej usługi.
Trzeba jednak pamiętać, że deklarowane 4 GB pamięci dotyczą modelu działającego w określonych warunkach, a nie całej aplikacji. Przy projektowaniu asystenta na swoim sprzęcie warto uwzględnić także pozostałe elementy systemu i sprawdzić, jak działa całość.
3. AccuRanker sugeruje, że błędne dane od Google przekłamują wyniki ich narzędzia
AccuRanker ostrzega przed problemem, który może sprawić, że raporty SEO pokażą nagły spadek pozycji, mimo że niekoniecznie doszło do rzeczywistego pogorszenia widoczności.
Chodzi o tzw. poisoned SERPs, jak nazywa to sama firma – czyli nieprawidłowe wyniki wyszukiwania pobierane automatycznie z Google. Na pierwszy rzut oka wszystko jest z nimi ok, ale mogą zawierać inny zestaw stron niż standardowe wyniki.
Narzędzie może więc błędnie uznać, że monitorowana witryna straciła pozycje.
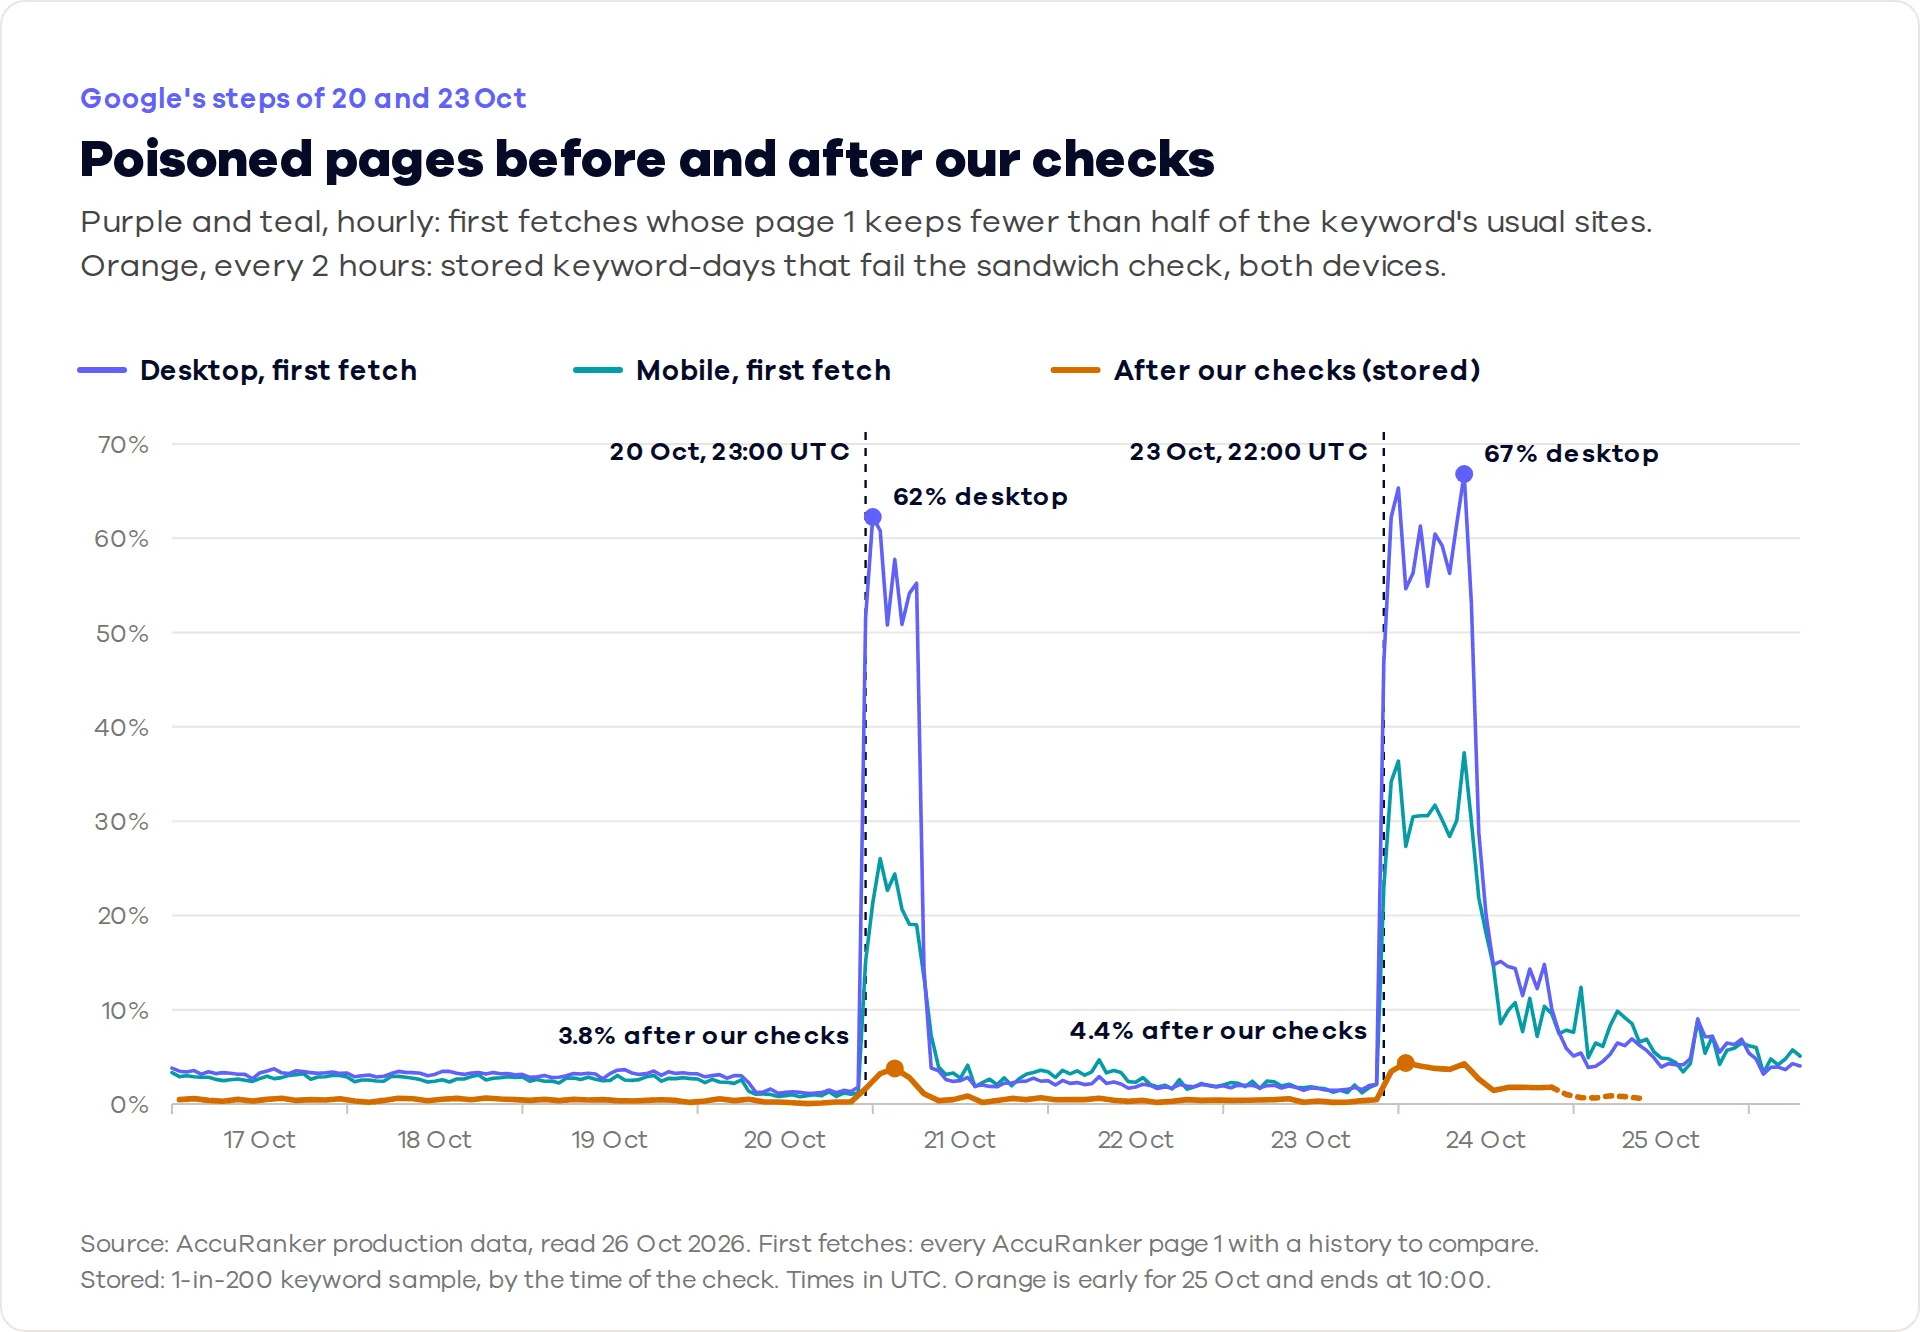
Według danych AccuRanker 24 października problem występował w 40% początkowych pobrań wyników na komputerach. Po zastosowaniu dodatkowych kontroli, odsetek podejrzanych danych zapisanych w systemie był znacznie niższy i wyniósł 3,23%. Dzień później spadł do 0,57%.
Co to oznacza w praktyce? Jeśli korzystasz z Accurankera i nagle zobaczysz, że ważna fraza spadła z pierwszej dziesiątki na odległą pozycję, nie musisz panikować.
Najpierw wypadałoby sprawdzić, czy zmianę potwierdzają dane z Search Console. Tutaj ważne będą kliknięcia, wyświetlenia i średnia pozycja dla konkretnego zapytania, które warto porównać z wynikami z kolejnych dni.
Pozycje z zewnętrznych narzędzi i średnia pozycja w Search Console nie są bezpośrednio porównywalnymi wskaźnikami. Natomiast jeśli gwałtownemu spadkowi towarzyszy również zmniejszenie liczby kliknięć i wyświetleń, problem być może faktycznie występuje i wymaga dalszej analizy.
Podejmowanie ważnych decyzji dot. pozycjonowania na podstawie pojedynczego, dziwnego odczytu nigdy nie jest zalecane.
4. S. Pichai twierdzi, że wyszukiwarka zostanie włączona do warstwy „agentowej”
Google chce połączyć wyszukiwarkę i narzędzia AI za pomocą tzw. warstwy agentowej (agentic layer).
Sundar Pichai, szef firmy, wyjaśnił w ostatnim wywiadzie, że celem nie jest koniecznie stworzenie jednej aplikacji, która zastąpi Google Search i Gemini.
Chodzi raczej o zaprojektowanie ekosystemu, w którym różne usługi współpracowałyby ze sobą, a użytkownik mógłby płynnie przechodzić między nimi bez konieczności rozpoczynania każdego zadania od nowa.
Agenty AI mają nie tylko wyszukiwać informacje, ale też realizować wieloetapowe polecenia, korzystać z dostępnych narzędzi i pamiętać kontekst poprzednich działań.
Google rozwija w tym kierunku między innymi Gemini Spark, który został zapowiedziany na evencie Google I/O w maju tego roku. To projekt zaawansowanego agenta, który łączy możliwości wyszukiwania z pracą w przeglądarce – również bez udziału użytkownika.
Pichai zapowiada też rozwój wspólnej infrastruktury dla klientów indywidualnych i biznesowych. W przypadku firm na pierwszym planie mają być mechanizmy bezpieczeństwa, monitorowanie działań agentów oraz możliwość ich audytowania.
Wygląda na to, że Google chce przekształcić wyszukiwanie w część większego środowiska AI, które rozumie kontekst i pomaga realizować zadania od początku do końca.
5. Google: Kod HTTP 503 jest kluczowy podczas przestojów strony
Jeśli planujesz wyłączyć stronę na czas aktualizacji lub naprawy serwera, warto pamiętać o kodzie HTTP 503. Google przypomniało o tym przy okazji awaryjnych poprawek bezpieczeństwa PHP.
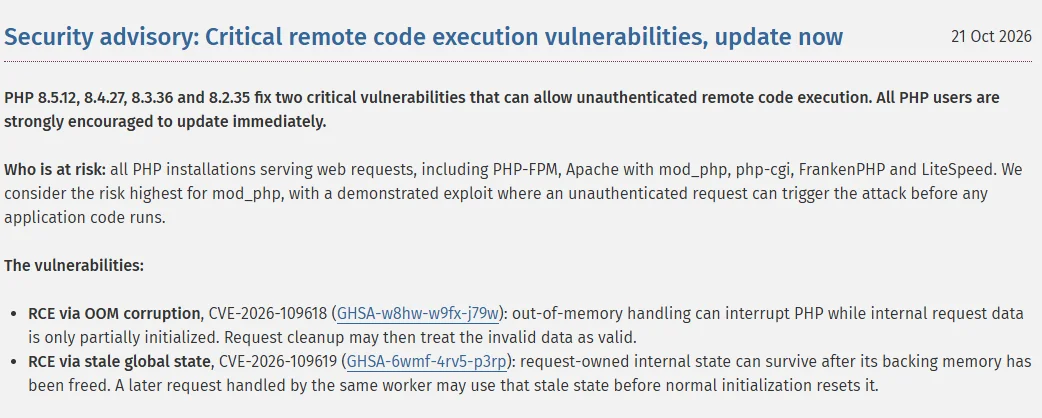
Taki status informuje wyszukiwarkę, że serwis jest chwilowo niedostępny, ale powinien wrócić do działania. Dzięki temu Google nie potraktuje adresów URL tak, jakby zostały usunięte.
Ważne jest jednak to, żeby przesadnie nie przeciągać przerwy. Google zaleca, by nie zwracać kodu 503 przez dłużej niż dzień lub dwa. Jeśli robot wyszukiwarki przez kilka dni będzie trafiał na błędy serwera, część adresów może zwyczajnie wypaść z indeksu.
Trzeba też uważać na sposób obsługi awarii – w sytuacji, gdy strona wyświetla komunikat o niedostępności, ale zwraca kod 200 OK, Google może potraktować taką informację jak zwykłą treść. Z kolei kod 404 sugeruje, że strona nie istnieje.
Jeśli podczas aktualizacji wyłączasz PHP, odpowiedź 503 musi być generowana niezależnie od niego, np. na poziomie serwera lub CDN-u.
Warto też zadbać o dostępność pliku robots.txt, ponieważ błąd 503 pod jego adresem może utrudnić Googlebotowi crawlowanie witryny. Przy większej liczbie błędów serwerowych Google może dodatkowo ograniczyć częstotliwość odwiedzania całej domeny.
Warto wiedzieć
Przy krótkiej przerwie technicznej najlepiej zwracać 503, sprawdzić, czy serwer faktycznie wysyła ten status, i jak najszybciej przywrócić prawidłowe odpowiedzi 200.
6. Wsparcie formatu JPEG XL w wyszukiwarce – co warto wiedzieć?
Format zdjęć JPEG XL cieszy się coraz większą popularnością, ale jest pewien problem – Google w swojej dokumentacji nie wymienia go wśród wspieranych opcji. Nie ma go też na liście plików, które mogą być indeksowane.
Warto wiedzieć
JPEG XL może zapewniać lepszą kompresję niż tradycyjny JPEG, a jednocześnie zachowuje wysoką jakość obrazu. Obsługuje też kompresję bezstratną i HDR. Z perspektywy właściciela strony może być atrakcyjnym rozwiązaniem, szczególnie przy dużej liczbie zdjęć.
Co ciekawe – przeglądarki (Safari, Firefox, Chrome) mogą prawidłowo wyświetlać takie pliki, ale to nie oznacza automatycznie, że Google potrafi wykorzystać je w swoich usługach, np. w Grafice czy w podglądach Google Discover. Potwierdził to John Mueller.
Tymczasowym rozwiązaniem może być udostępnianie obrazów w kilku formatach.
Można wykorzystać JPEG XL dla zgodnych przeglądarek, a jednocześnie pozostawić zapasową wersję, np. WebP lub AVIF, w standardowym znaczniku <img>.
Warto też sprawdzić metadane og:image i dane strukturalne schema.org, bo to z nich Google może pobierać grafiki do podglądów. Jeśli wskazują bezpośrednio na plik .jxl, lepiej upewnić się, że dostępna jest również wersja w innym, obsługiwanym formacie.
Historia AVIF pokazuje, że na wdrożenie obsługi w wyszukiwarce można czekać znacznie dłużej niż na wsparcie przeglądarek. Dlatego na razie najlepiej testować JPEG XL bez usuwania wersji zapasowych – no i śledzić oficjalne komunikaty Google.
Autor artykułu

Szymon Anioł
Szymon tworzy SEO Newsy i redaguje artykuły ekspertów na naszym blogu. Pisanie do internetu to dla niego czysta frajda, zwłaszcza gdy może wykazać się kreatywnością. Interesuje się neuro- i psychomarketingiem. Po godzinach miłośnik dobrej muzyki, filmów i podróży.